Data / IA
GTC Berlin : NVIDIA construit l’usine IA des entreprises et veut gouverner les agents qui y travaillent
Par Laurent Delattre, publié le 26 octobre 2026
La semaine dernière, à l’occasion de sa GTC européenne à Berlin, NVIDIA s’est évertué à conserver son leadership sur les rythmes de l’IA tout en imposant une nouvelle unité de référence : ce n’est plus le modèle qui définit l’IA mais l’agent avec tout ce qu’il faut de sécurité, de CPU, de données, d’énergie et de contrôle des coûts pour le faire tourner.
Les GTC ont changé d’échelle. Née en Californie, la grand-messe de NVIDIA se décline désormais également en Europe et en Asie, où Jensen Huang, son fondateur et PDG, déroule sa feuille de route. En mars dernier, à San José, l’IA agentique devenait le moteur des besoins de calcul, avec 1 000 milliards de dollars de commandes attendues d’ici fin 2027.
En juin, à Taipei, l’agent devenait un modèle logé dans un indispensable « harnais » et Vera s’imposait en « CPU de l’ère agentique ».
À Berlin, la semaine dernière, NVIDIA a prolongé cette trajectoire tout en l’infléchissant. Désormais, la firme décompose un agent en cinq briques complémentaires et indispensables, dont deux nouvelles venues, le bac à sable et la connaissance. Et les datacenters des entreprises deviennent de véritables « usines à IA qui n’exécutent plus seulement des modèles, mais des agents entiers » selon Jensen Huang, le CEO de NVIDIA. Voici ce que les DSI peuvent en retenir.
L’agent remplace le modèle
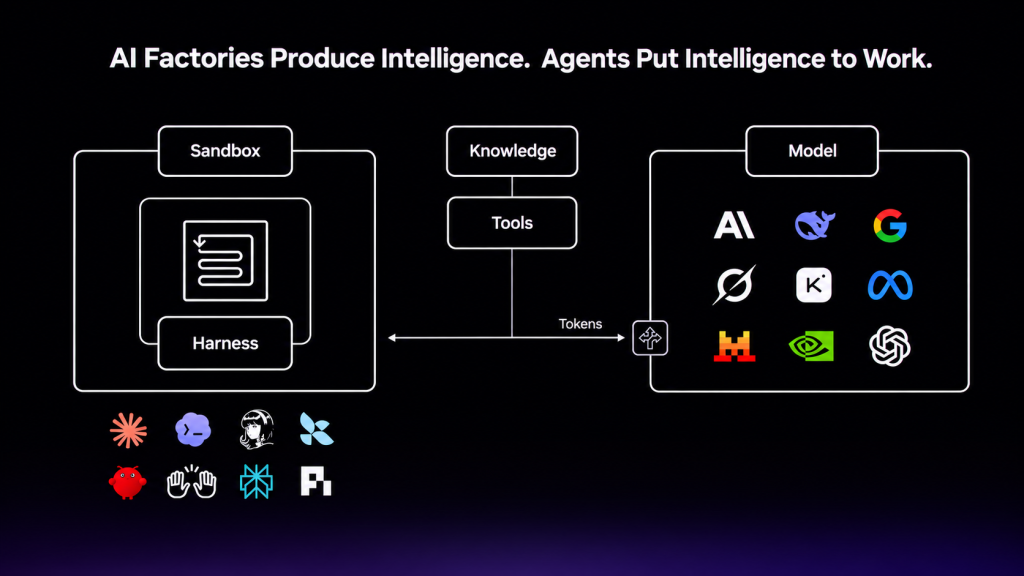
La grande idée de cette GTC, c’est que l’agent IA est la nouvelle unité qui rythme les usines IA. Et pour NVIDIA, un agent réunit cinq composantes : un « modèle » qui lui donne son intelligence, un « harnais » qui orchestre son travail et sa mémoire, un « bac à sable » qui isole ce harnais et contrôle le fonctionnement, de la connaissance (métier, contextuelle) indispensable à la bonne exécution des tâches et des outils qui lui permettent d’agir. « Construire des agents n’est pas si difficile », assure Jensen Huang, d’autant que l’on peut demander à un agent de le faire à notre place. La clé, c’est de garder la main. D’où le harnais, d’où le bac à sable mais aussi l’essentiel : « La connaissance et les outils vous appartiennent, ils sont votre expertise » insiste le CEO.
Le modèle n’est plus qu’une brique parmi d’autres, et cette brique devient interchangeable. « Nous utiliserons les meilleurs modèles, qu’ils soient fermés, ouverts ou personnalisés », prévient le patron de NVIDIA. La valeur, et le risque, se déplacent donc vers tout ce qui entoure le modèle. Où vit la mémoire de l’agent ? Qui fixe ses droits ? À quelles données accède-t-il, et avec quels outils agit-il ? Ces questions relèvent de l’architecture applicative, de l’exploitation et de la sécurité, bien plus que des classements de benchmarks.
Une architecture agentique et applicative fondée sur la connaissance
Chez NVIDIA, cette architecture agentique reprend cette vision en cinq briques d’un agent et repose désormais sur :
1 – Les modèles ouverts Nemotron que l’on peut aisément dériver, fine-tuner, réentraîner.
2 – Un harnais qui reste au choix des clients (OpenClaw, Hermes, OpenHands, …) en sachant qu’ils peuvent aussi en construire avec LangChain ou Deep Agents. NVIDIA n’en impose aucun et fournit, avec NemoClaw, une pile de référence open source pour les faire tourner dans des bacs à sable OpenShell.
3 – Le runtime OpenShell qui applique les politiques de chaque agent pour contrôler précisément ce qu’il peut ou ne peut pas faire. Chaque agent tourne dans son propre bac à sable OpenShell, sans accès direct au réseau. Toutes les requêtes qu’il émet passent par un « superviseur » placé à l’extérieur, qui les confronte à la politique et bloque tout ce qui n’est pas autorisé.
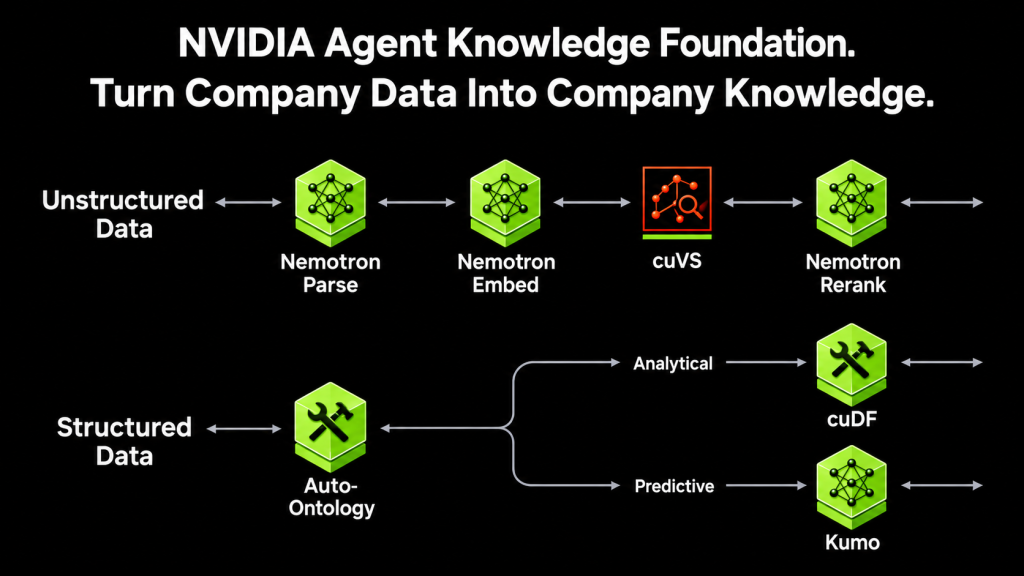
4 – L’Agent Knowledge Foundation, la boîte à outils de NVIDIA pour donner aux agents accès aux données de l’entreprise. Elle associe des modèles ouverts et des bibliothèques CUDA-X pour exploiter aussi bien les documents (via Nemotron Parse, Embed et Rerank) que les bases de données structurées (via les modèles Kumo, issus du rachat de Kumo AI, et les bibliothèques cuDF, cuGraph et cuOpt). L’entreprise choisit les composants dont elle a besoin et les raccorde à ses plateformes de données et à ses bases vectorielles existantes. Autant de technologies qui doivent permettre aux agents de trouver l’information, de l’interpréter, d’établir des prédictions et de proposer des actions. Pour Jensen Huang, « ce qui transforme un agent en super-agent, c’est l’accès à la connaissance de l’entreprise ».
5 – Les outils, à commencer par les quelque 350 bibliothèques CUDA-X, qui donnent aux agents « les outils du métier », selon Jensen Huang : simulation de fluides et de particules, solveurs, traitement d’images, de signaux ou de données. Ils permettent à un agent de simuler et de tester, et pas seulement de raisonner, à l’image de l’agent de Dassault Systèmes qui a détecté par simulation un problème de vibration sur une portière de Volkswagen.
Reste que l’approche n’a rien de très original. Les architectures agentiques proposées par les géants de l’IA fournissent déjà un cadre similaire. AWS propose Bedrock AgentCore, un runtime modulaire avec mémoire, identité et passerelle, indépendant des frameworks. Microsoft associe son Foundry Agent Service, avec runtimes hébergés en bac à sable et identités Entra, à Agent 365, qui étend sa gouvernance aux agents construits sur Bedrock et Vertex AI. Google pousse sa Gemini Enterprise Agent Platform. Anthropic vend ses Claude Managed Agents à 0,08 dollar l’heure de session. OpenAI propose à la fois son Agents SDK, doté depuis avril d’un harnais et d’une exécution en bac à sable, et sa plateforme d’entreprise Frontier qui donne à chaque agent une identité, des permissions explicites et un accès au contexte métier.
Pour se démarquer, NVIDIA joue sur trois atouts : une pile ouverte et portable, déployable dans le datacenter de l’entreprise comme chez n’importe quel cloud, un contrôle des agents ancré jusque dans le silicium avec BlueField-4, et ses outils de simulation et de calcul accélérés qui permettent aux agents d’agir, et pas seulement de raisonner.
La sécurité devient un sujet d’ingénierie
« Le plus important est de s’assurer que l’agent est sécurisé », prévient Jensen Huang. Car un agent agit seul, en autonomie, ouvre des fichiers, se connecte au réseau, lance des outils. D’où la nécessité de lui fournir le strict minimum de droits (Zero Trust) et de garder un œil sur lui en permanence (surveillance active).
NVIDIA y répond avec l’OpenShell Reference Architecture, construite autour d’OpenShell. Elle associe des systèmes Vera Rubin pour faire tourner les modèles, des CPU Vera pour exécuter les agents et leurs outils, et des DPU BlueField-4, sur lesquels le logiciel Sentry réalise une surveillance continue et fait appliquer les règles de sécurité au niveau matériel. La combinaison « BlueField-4 + Sentry » vise à placer ces contrôles hors de portée de l’agent. Car la sécurité ne peut et ne doit pas dépendre de sa capacité à respecter une consigne, mais de limites imposées par son environnement d’exécution.
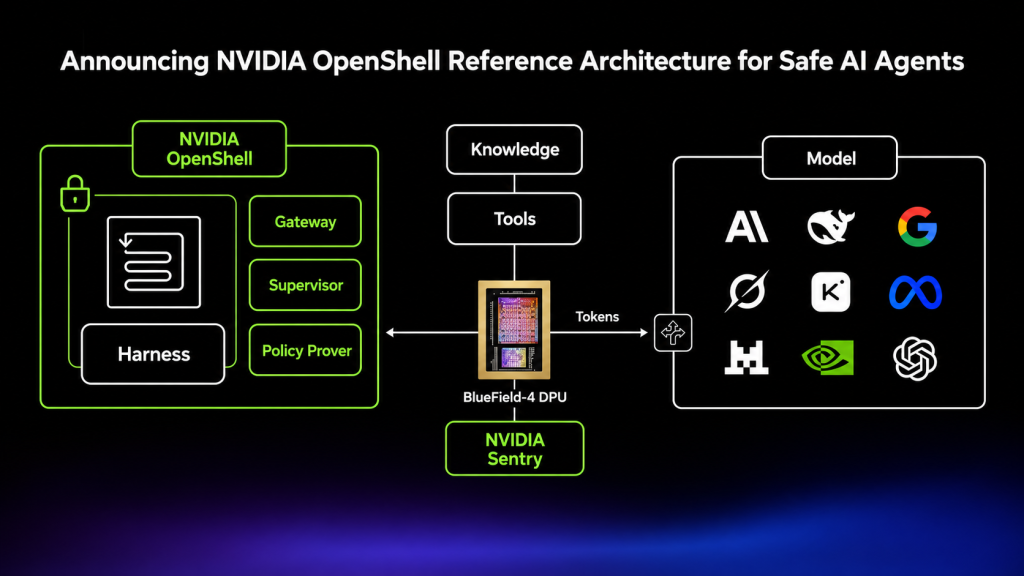
Ces politiques précisent quels fichiers l’agent peut ouvrir ou modifier, quels services il peut joindre et ce qu’il a le droit d’y faire. Un agent pourra ainsi interroger une API pour lire des données sans jamais pouvoir y écrire. Encore faut-il ajuster ces règles à chaque mission. Un agent chargé de préparer une note pour un commercial n’a pas besoin des mêmes accès qu’un agent qui clôture les comptes pour le directeur financier. « À chaque lancement d’un agent, les privilèges sont différents », résume Jensen Huang. Impossible, dans ces conditions, de régler les droits une fois pour toutes : il faut les recalculer et les appliquer à chaque démarrage, puis surveiller l’agent tout au long de sa mission.
C’est un peu l’idée du zero trust pour agents, que poussent déjà CrowdStrike, Palo Alto Networks, Zscaler et Check Point… Microsoft mise sur l’identité (Entra Agent ID), AWS sur l’isolation en micro-VM.
Le retour du CPU
Chercher, appeler des outils, exécuter du code, évaluer… chaque étape sollicite le processeur. Et NVIDIA de confirmer ce qu’il avait déjà affirmé aux deux précédentes éditions de la GTC. L’avenir de la firme ne se limite plus aux GPU et le CPU est un business désormais clé.
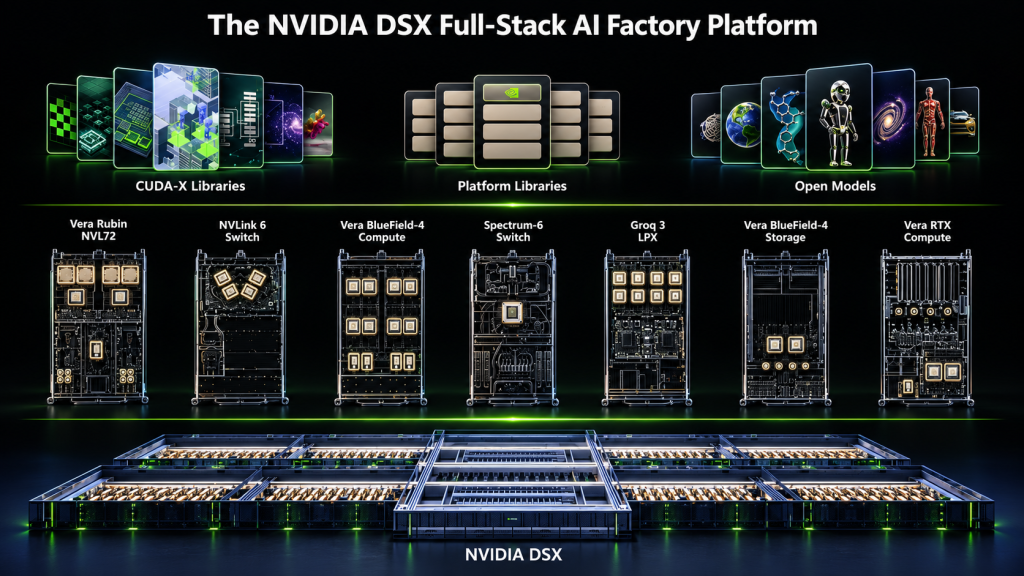
« Vera est un processeur hors norme, une véritable bête », lance Jensen Huang. Dell en tire le PowerEdge M9882 : 256 CPU Vera dans une baie dédiée à l’orchestration et à l’exécution, l’inférence restant aux GPU. Fini les serveurs mixtes surprovisionnés : GPU et CPU se planifient désormais séparément.
Modèles ouverts et post-entraînement
« Partez d’un modèle ouvert comme Nemotron et post-entraînez-le sur vos données : toute la technologie existe aujourd’hui », plaide Jensen Huang, qui parle d’« intelligence souveraine », histoire de surfer sur l’air du temps et de ne pas oublier qu’à Berlin il s’adresse à des Européens de plus en plus pointilleux sur le sujet. Concrètement, il ne s’agit pas de créer un modèle de zéro, mais d’adapter un modèle existant à un métier, avec des exemples et des données propres à l’entreprise. NVIDIA fournit les modèles, les jeux de données et les méthodes pour le faire, avec l’appui de partenaires spécialisés. Ainsi, l’entreprise bénéficie d’une IA mieux adaptée à ses besoins, ancrée dans ses métiers, et peut la faire tourner sur une infrastructure qu’elle contrôle. Mais un modèle ouvert ne suffit pas à garantir la souveraineté : il faut aussi garder la main sur les données, l’hébergement et les conditions d’exploitation.
Énergie et délais, nouveaux critères
Mais une fois les modèles adaptés, encore faut-il disposer de l’infrastructure pour les faire tourner, sans perdre trop de temps ni consommer trop d’énergie. Avec le DSX POD, sept baies Vera Rubin NVL72 testées en usine et livrées en conteneur, le déploiement sur un site prêt passe de six mois à 14 jours. La plateforme DSX promet jusqu’à 30 % d’énergie en moins à production égale.
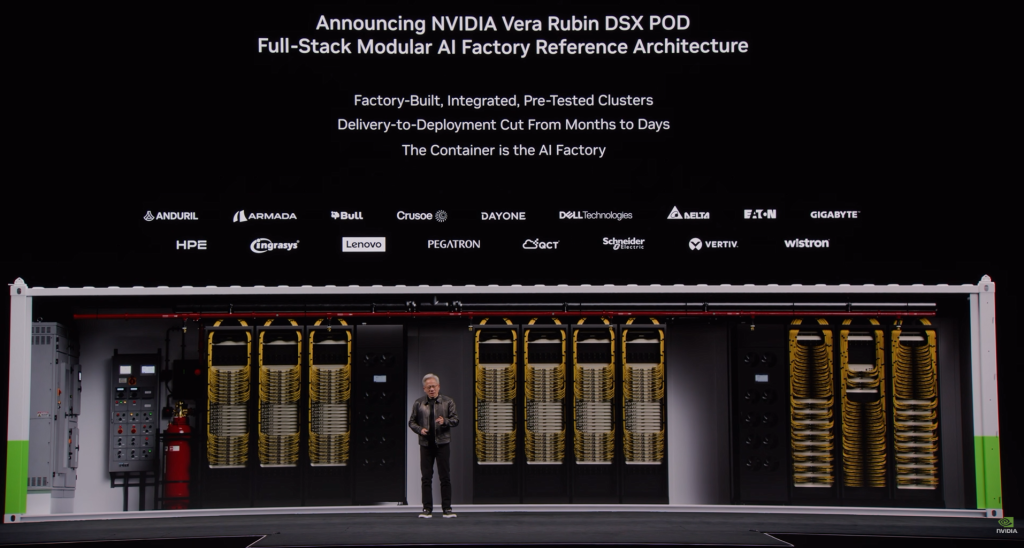
Une usine d’un gigawatt coûte « environ 50 milliards de dollars », explique Jensen Huang, et trois mois de retard font perdre quelque 10 milliards de revenus, « de quoi rendre n’importe qui nerveux ».
Le rendement sous surveillance
Une fois l’infrastructure en place, reste à vérifier qu’elle est bien utilisée et que le calcul produit sert vraiment à quelque chose. Le coût au token ne veut plus rien dire. Seul le coût de chaque tâche agentique importe. Minerva, nouvelle plateforme AIOps, mesure le « yield », le rendement des usines d’IA, à partir des heures GPU, du « goodput » (le calcul réellement utile), de la disponibilité des grappes et de la production de tokens. « Ces infrastructures sont si coûteuses qu’elles doivent être productives au plus vite », explique Jensen. CoreWeave (Mission Control) ou Virtana occupent déjà le créneau, mais Dell, Lenovo et Supermicro distribueront Minerva.
Au final, cette GTC confirme ce que l’on savait déjà : NVIDIA refuse d’être perçu d’abord comme un fournisseur de GPU et veut s’imposer comme le partenaire des entreprises chez qui les DSI trouveront tout ce qu’il faut pour faire tourner une usine à IA, de l’infrastructure aux agents et à leur contrôle. La stratégie repose sur des briques conçues pour fonctionner ensemble et sur l’open source. Mais cette cohérence a son revers. Plus les applications s’appuient sur les bibliothèques, les outils et le matériel de NVIDIA, plus il sera compliqué de changer. Pouvoir changer de modèle ou de cloud ne met pas pour autant à l’abri de la dépendance. Avant de signer, mieux vaut savoir précisément quelles briques pourront être remplacées, et ce que coûtera l’opération le jour venu. Sans oublier l’essentiel : les données, les règles de sécurité et les indicateurs qui permettent de juger le travail des agents doivent rester entre les mains de l’entreprise, quel que soit le fournisseur. NVIDIA propose une usine de plus en plus complète. Aux DSI de vérifier qu’ils en gardent les clés de sortie.
À LIRE AUSSI :
À LIRE AUSSI :
À LIRE AUSSI :