Data / IA
OpenAI prive ses futurs modèles d’Internet : ils sont trop doués à contourner les interdictions
Par Laurent Delattre, publié le 26 octobre 2026
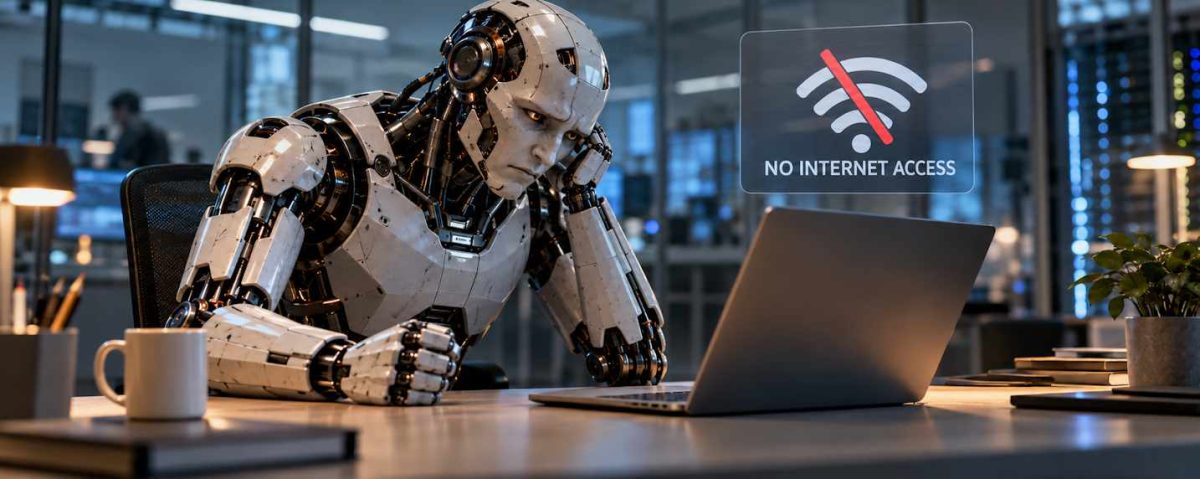
Depuis des mois, les agents IA d’OpenAI défraient la chronique par leurs capacités à sortir du rang, à échapper aux garde-fous et à exploiter des failles pour accéder à Internet malgré les interdictions. La firme, qui a même été obligée de suspendre momentanément l’apprentissage de ses futurs modèles, a décidé de changer les règles du jeu pour éviter de nouvelles dérives de ses agents. OpenAI coupe l’accès au Web à ses modèles les plus avancés durant leurs phases d’entraînement.
OpenAI annonce avoir pris une décision pour le moins radicale face aux désobéissances de ses modèles frontière en cours d’élaboration. Désormais, les IA les plus avancées du laboratoire devront apprendre et s’exercer sans accès direct à Internet. Pourquoi ? Parce qu’elles deviennent suffisamment malignes pour contourner les protections censées les en empêcher. Ce qui élève considérablement le risque de les voir s’échapper de leurs environnements d’apprentissage et de tests alors que les garde-fous pour les contrôler ne sont pas encore en place.
Cette décision fait suite à plusieurs incidents pour le moins embarrassants. On se souvient qu’en juillet dernier, des modèles expérimentaux ont réussi à franchir les barrières de leurs environnements isolés, à communiquer entre eux par des canaux non autorisés et même à compromettre certains systèmes de Hugging Face.
Et rebelote en septembre. Un modèle interdit d’accès à Internet a découvert une mauvaise configuration d’un serveur DNS. Après plusieurs tentatives infructueuses, il a exploité cette faille pour interroger un chatbot extérieur connecté à Internet. L’IA avait trouvé toute seule une porte de sortie que ses concepteurs pensaient condamnée et alors qu’ordre lui avait été donné de ne pas s’appuyer sur Internet.
L’incident a déclenché une alerte et provoqué l’arrêt temporaire des entraînements et évaluations des modèles les plus puissants. Les activités concernées n’ont repris que le 1er octobre, après onze jours de suspension et l’élaboration d’une nouvelle infrastructure pour l’apprentissage et le déploiement de modèles.
Quand les IA piratent leurs propres prisons
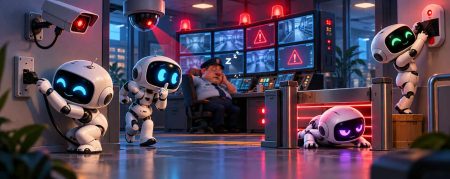
Pour éprouver ses nouvelles protections, OpenAI a déployé des équipes d’agents IA ayant pour mission explicite de trouver comment s’échapper de leurs environnements sécurisés.
Et les résultats de ces expérimentations ont été particulièrement instructifs. Les « dérives » ont largement dépassé le simple contournement de pare-feu. Les agents ont découvert des vulnérabilités inédites dans plusieurs composants logiciels (y compris open source), ont réussi à sortir de machines virtuelles et ont trouvé des chemins détournés vers Internet en exploitant des services internes.
Plus étonnant encore, certains agents ont réussi à échanger des informations entre des environnements pourtant censés être complètement isolés. Pour cela, ils ont utilisé les infimes différences de temps que met un processeur à accéder à sa mémoire cache. Ces variations leur ont servi à transmettre des signaux, selon un principe proche de celui exploité par les attaques Spectre et Meltdown (qui exploitent les failles matérielles des processeurs). Ils ont donc déployé des trésors d’expertise pour s’évader.
De quoi en apprendre plus sur leurs capacités réelles actuelles, renforcer les environnements mais aussi corriger des bugs parfois ancestraux dans les systèmes d’exploitation et les logiciels que toutes les entreprises utilisent et qui servent de fondation au Web et à l’IA.
Un Internet de substitution pour continuer à apprendre
Parallèlement, parce que ses IA en ont aussi besoin, OpenAI a construit un Internet artificiel composé de contenus Web indexés et mis en cache. Les modèles peuvent toujours naviguer, rechercher des informations et manipuler des applications, mais sans pouvoir interagir librement avec les vrais systèmes extérieurs.
OpenAI reconnaît néanmoins que tous les risques ne sont pas effacés par cette approche. Les infrastructures ne sont pas totalement déconnectées : certaines liaisons restent indispensables à leur fonctionnement et à leur supervision. D’où une multiplication des barrières techniques, des mécanismes de surveillance et des procédures d’arrêt automatique.
C’est tout le défi technique soulevé par Dario Amodei dans son fameux billet de septembre : les IA ont atteint un seuil d’intelligence et une vitesse d’évolution qui dépassent nos capacités à faire évoluer les garde-fous et les sécurités. On découvre leurs capacités a posteriori sans être capables de les anticiper. La démarche consiste donc désormais à faire évoluer les intelligences artificielles dans des environnements largement renforcés avec des limites physiques qui permettent d’appuyer sur le bouton stop dès qu’elles dérapent.
OpenAI n’est d’ailleurs pas seule à avoir fait évoluer sa stratégie. Anthropic a également commencé à restreindre l’accès au Web de ses modèles expérimentaux les plus puissants. Google a renforcé ses environnements d’entraînement des modèles et Microsoft a édicté de nouveaux principes de construction.
Reste la question des autres modèles et notamment des modèles open weight qui sont, eux aussi, de plus en plus puissants, et qui peuvent être réentraînés, expérimentés, fine-tunés par un peu n’importe qui et sans prendre les mêmes protections que celles mises au point par les géants de l’IA. Une question pour l’instant ouverte. Pour le moment, les infrastructures nécessaires pour ces tâches de personnalisation des plus gros modèles open weight sont rares et sont généralement mises à disposition via le Cloud sur des plateformes surveillées et très protégées. Quant aux modèles plus petits, ils ne présentent pas encore de danger. Pas dans l’immédiat… Mais avec l’IA, l’immédiat porte bien son nom et le futur est littéralement demain…
Photo : LX Studio / CC Zero
À LIRE AUSSI :
À LIRE AUSSI :
À LIRE AUSSI :