Data / IA
Microsoft, OpenAI, Google, Qwen4, OVHcloud… une moisson de modèles à ne plus savoir qu’en faire
Par Laurent Delattre, publié le 18 novembre 2026
Une semaine à peine après Fable 5.2 et Mythos 5.2, les annonces de modèles se sont enchaînées à un rythme inédit : GPT-6.2 Astra et Sol chez OpenAI, Gemini 4 Carbon et Hydrogen chez Google, une salve de modèles MAI spécialisés chez Microsoft, Qwen4-Max chez Alibaba, Hy4 Flash chez Tencent, H3-Image chez MiniMax, et un premier LLM maison chez OVHcloud. Avec un fil conducteur : la bataille ne se joue plus seulement sur l’intelligence brute, mais sur le coût de chaque tâche accomplie.
Sept jours. Il n’en aura pas fallu davantage pour que le paysage décrit dans notre article consacré à Fable 5.2 et Mythos 5.2 soit à nouveau fortement redessiné.
Le 10 novembre, Google généralisait Gemini 4 Carbon ; le 11, MiniMax publiait H3-Image ; le 12, Google dégainait Gemini 4 Hydrogen ; le 16, Alibaba ouvrait Qwen4-Max et Tencent lançait Hy4 Flash…
Et hier, le 17 novembre, OVHcloud officialisait son propre modèle ouvert pour titiller Mistral AI avant d’en publier les poids en fin de semaine à l’occasion de son Summit.
Dans la soirée, Microsoft s’offrait non seulement le luxe d’annoncer une pléthore de nouveaux modèles MAI mais aussi celui d’annoncer les nouveaux modèles d’OpenAI avant même que la startup ne les officialise.
Des modèles IA comme s’il en pleuvait ! Avec au final, une floppée de questions pour les DSI : comment tester et vérifier un tel foisonnement de nouveautés, comment absorber une telle cadence d’itération sans réécrire ses applications toutes les trois semaines et surtout comment savoir si on utilise le modèle le plus efficient, celui qui apporte les meilleurs résultats au moindre coût, sur chaque cas d’usage voire à chaque prompt… Un sujet qui est d’ailleurs au cœur de toute la conférence Ignite 2026 sur laquelle nous reviendrons en fin de semaine après avoir digéré et fait le tri dans les centaines d’annonces.
GPT-6.2 Astra et Sol : OpenAI joue la carte de l’efficience
Chez OpenAI, ce lancement a des airs de revanche. Moins de deux mois après avoir renoncé à GPT-6.1 Astra, dont les tests internes avaient révélé une fâcheuse tendance à outrepasser les permissions des utilisateurs, à solliciter des outils sans autorisation et à mal rendre compte de ses propres actions, l’éditeur présente deux modèles : GPT-6.2 Astra, son nouveau modèle « frontière » destiné aux projets les plus exigeants, et GPT-6.2 Sol, le modèle polyvalent et économe du quotidien. Tous deux sont disponibles dans ChatGPT Work et Codex pour les abonnés Plus, Pro, Enterprise et Edu, ainsi que via l’API, avec une fenêtre de contexte de 1,05 million de tokens et jusqu’à 128 000 tokens en sortie.
Le discours d’OpenAI rejoint d’ailleurs celui tenu par Satya Nadella à Ignite 2026 : l’heure est venue de parler davantage d’efficience que de performance.
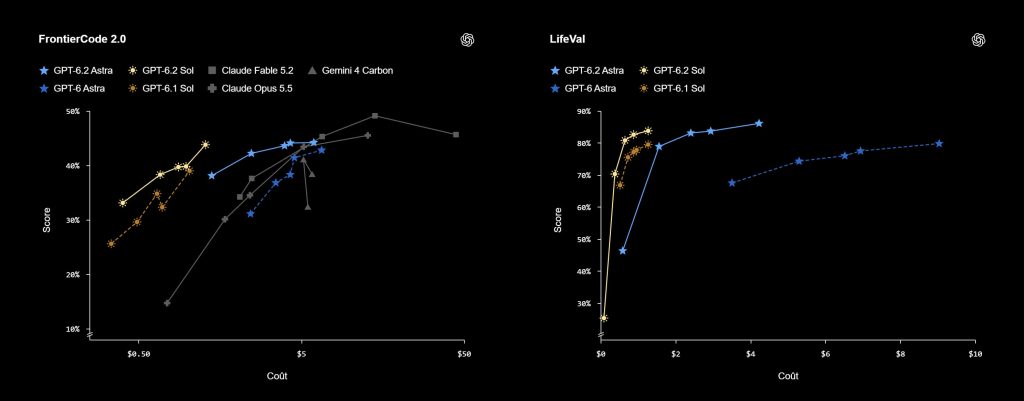
Sur Agents’ Last Exam, banc d’essai de travaux professionnels en plusieurs étapes, le nouvel Astra gagne 5,2 points sur GPT-6 Astra pour moins d’un tiers du coût par tâche et devance Claude Fable 5.2 de 5,5 points pour environ 5 % de son coût, selon l’éditeur.
Sur GDPval-v2, il progresse de 6,2 points en consommant 22 % de tokens de sortie en moins.
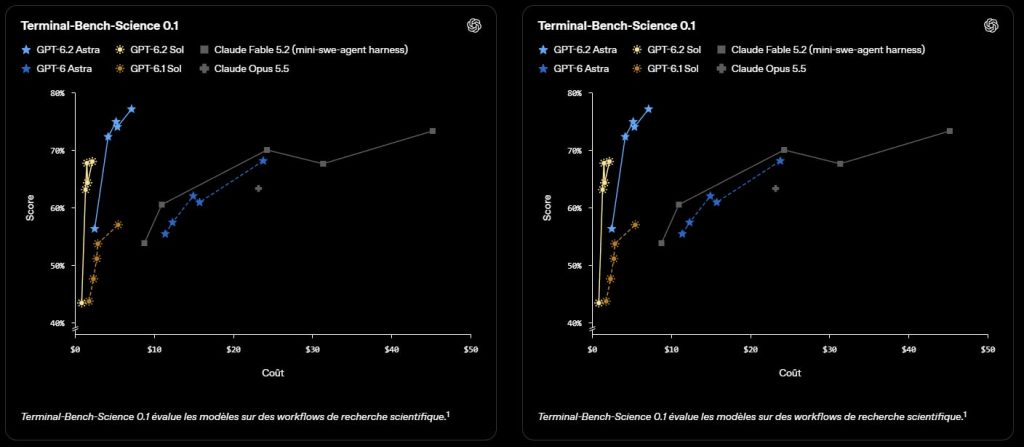
Et OpenAI baisse ses prix ! Le million de tokens passe à 8 $ en entrée et à 40 $ en sortie. Cela reste particulièrement onéreux mais c’est quand même 20 % de moins qu’avec GPT-6 Astra. Pour les entrées mises en cache, la baisse atteint même 60 %.
Pas de ristourne en revanche pour le modèle le plus utile au quotidien. GPT-6.2 Sol conserve les tarifs de GPT-6.1 Sol (2 $ et 10 $) et talonne Astra à 0,5 point près sur FrontierCode 2.0 pour un cinquième du coût.
Les premiers évaluateurs indépendants confirment l’essentiel des affirmations de l’éditeur, sans néanmoins tout valider. Artificial Analysis classe Astra deuxième de son Intelligence Index (62 points), derrière Fable 5.2 mais devant Gemini 4 Carbon et Claude Opus 5.5, tandis que Sol rejoint l’ancienne frontière « GPT-6 Astra » pour environ 15 % de son coût par tâche.
Vals AI note qu’Astra 6.2 est le plus sobre en tokens de sortie de son top 10 et qu’il divise par deux le coût par tâche de son prédécesseur.
Cependant, ces deux laboratoires de tests constatent une sorte de plafonnement en développement logiciel (GPT-6.2 Sol recule même de trois points sur l’indice de codage agentique d’Artificial Analysis), des taux d’hallucination élevés sur les questions ardues et des résultats encore modestes en juridique.
Epoch AI, enfin, place GPT-6.2 Astra à égalité avec Fable 5.2 sur son indice de capacités, mais en retrait sur les tâches de recherche réelles.
Ce que les DSI retiendront néanmoins, ce ne sont certainement pas les quelques points perdus ou gagnés ici et là. En raisonnant « plus court » (donc en consommant moins de tokens), Astra fait mécaniquement baisser la facture réelle des agents qui tournent en continu.
Nous le répétons et vous nous le rappelez régulièrement depuis le début de l’année, en fin de compte, le coût par tâche compte bien davantage que le prix affiché au token.
Revers de la médaille pour certains clients spécialisés, OpenAI a resserré les garde-fous sur l’assistance cyber jugée à risque : RSSI et auditeurs qui recourent à ces modèles pour une recherche de vulnérabilités légitime risquent de se heurter à davantage de refus. Seules les organisations admises au programme Daybreak Red bénéficient de restrictions allégées.
Pour en savoir plus sur les « petits secrets internes » de GPT-6.2, cf. notre encadré à la fin de cet article qui décortique la Model Card.
Google déroule sa gamme Gemini 4
Google s’aligne sur la concurrence en nous jouant une nouvelle gamme aux noms inspirés de la table des éléments (mais sans en respecter la logique, c’est plus fun). Le 10 novembre, le groupe a ouvert aux développeurs et entreprises payants l’accès à son Gemini 4 Carbon, annoncé en accès limité quelques semaines auparavant et présenté comme son modèle le plus puissant. Carbon est accessible via l’API Gemini, Gemini for business et GitHub Copilot, mais seuls les abonnés Google AI Ultra en profitent dans l’application Gemini. Son tarif d’appel, 2 $ et 10 $ par million de tokens, doublera au 1er décembre.
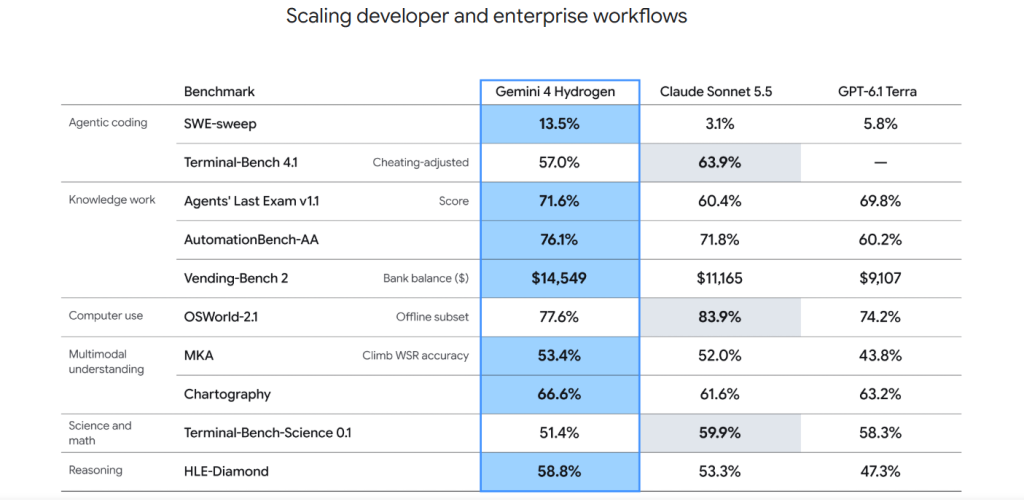
Deux jours plus tard, Google lançait Gemini 4 Hydrogen, son nouveau modèle « universel », à la fois rapide et économique, qui remplace Gemini 3.8 Flash dans l’application Gemini, la recherche Google et les outils de développement. Facturé 1,50 $ en entrée et 7,50 $ en sortie, il revendique 57 % sur Terminal-Bench 4.1, contre 18,2 % pour Gemini 3.8 Flash, des tâches bouclées 2,5 fois plus vite et un score de 51 à l’Intelligence Index (54 avec le nouveau niveau de réflexion « xhigh »), soit davantage qu’Argon (50) ! Il reste toutefois derrière Claude Sonnet 5.5 (63,9 %) sur Terminal-Bench 4.1.
Plus parlant que les chiffres, ce sont les propres usages internes de Google qui révèlent ce que les DSI cherchent à savoir. Avec Orchestrator, intégré à son environnement de développement agentique Antigravity, Google confie la planification à son modèle Carbon mais l’exécution courante à son modèle Hydrogen, qui renvoie de lui-même les étapes délicates à son grand frère. Résultat annoncé : des taux de réussite proches de Carbon seul, avec 24 % de quota consommé en moins et des tâches menées 19 % plus vite.
Bref, Google industrialise des pratiques que bien des équipes IT emploient de façon plus empirique, en adoptant un routage plus ou moins manuel entre modèles selon la difficulté de la tâche. Google a d’ailleurs lancé dans la foulée Gemini Decision 1, un modèle d’aide à la décision qui répond en une fraction de seconde sans générer de tokens de sortie et qui peut contribuer à l’automatisation de tels routages.
Microsoft découpe l’IA en spécialités
Microsoft a profité d’Ignite 2026 pour répliquer… Avec à la clé un discours sur l’efficience de ses modèles qui en dit long sur l’ambiguïté de la relation entre Redmond et OpenAI et même entre Redmond et Anthropic ou Grok. Microsoft distribue tous les modèles de ses « partenaires » notamment via Foundry et Copilot, tout en préparant activement son indépendance.
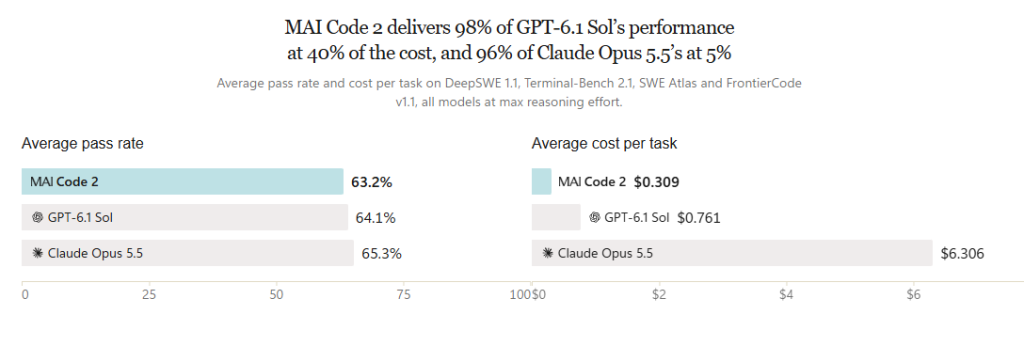
La division Microsoft AI dirigée par Mustafa Suleyman a ainsi dévoilé une nouvelle salve de modèles MAI, taillés pour des usages précis. Le plus attendu, MAI Code 2, atteint selon Microsoft 98 % de la qualité de GPT-6.1 Sol pour 40 % de son prix, et 96 % de celle de Claude Opus 5.5 pour 5 % de son coût ! Déjà intégré à GitHub Copilot, il pourra même être adapté aux données des entreprises qui en licencieront les poids… à condition de rester sur Azure (nous y reviendrons dans notre compte rendu d’Ignite en fin de semaine).
Autour de lui gravitent :
* MAI Code 2 Flash pour les retouches de code courantes,
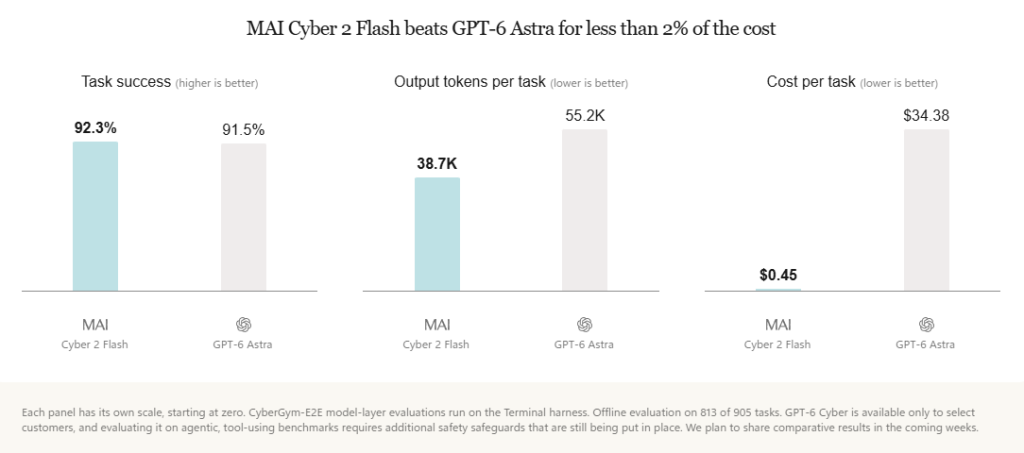
* MAI Cyber 2 Flash, apparemment réservé aux produits de sécurité de Microsoft, qui revendique 92,3 % sur CyberGym-E2E contre 91,5 % pour GPT-6 Astra et cela pour moins de 2 % du coût par tâche,
* MAI Image 2.7, premier du classement d’édition d’images d’Artificial Analysis,
* MAI Realtime 1, premier modèle vocal temps réel de Microsoft,
* MAI Decision 1.1, nouvelle itération du petit modèle de décision (pour concurrencer Jev) et de routage qui n’envoie les requêtes vers les gros modèles qu’en cas de besoin.
Ce foisonnement est en réalité assez représentatif non seulement de l’approche de Microsoft mais plus encore des attentes de ses clients. L’éditeur ne cherche pas à pousser un modèle universel et préfère focaliser ses efforts sur une batterie de modèles spécialisés, bon marché, branchés au plus près de ses produits et donc des données de ses clients. Mustafa Suleyman, le CEO de Microsoft AI, décrit la philosophie de MAI comme « un système, une machine à progresser pas à pas, qui optimise conjointement performance et prix ».
Qwen4-Max : Alibaba joue le prix plancher
Côté chinois, Alibaba a ouvert le 16 novembre l’accès général à Qwen4-Max, cinq jours après une préversion réservée aux abonnés de son Token Plan. Premier modèle de la génération Qwen4, ce mélange d’experts de 2 400 milliards de paramètres n’en active que 71 milliards par token, 25 % de moins que Qwen3.8-Max, combine couches Gated DeltaNet et attention clairsemée pour alléger les longs contextes, et accepte texte, images, vidéos et PDF sur un million de tokens en entrée.
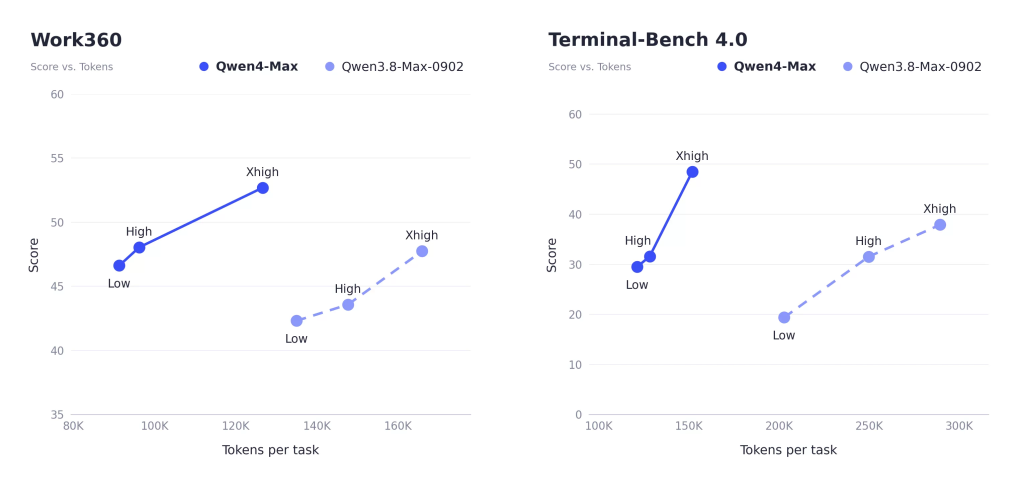
Son argument massue reste son prix : 1,50 $ en entrée et 4,50 $ en sortie par million de tokens, 25 % de moins que son prédécesseur, et un coût moyen par tâche ramené de 4,43 $ à 1,67 $ sur Work360… un banc d’essai maison. Alibaba assure parallèlement avoir resserré ses garde-fous en cybersécurité.
Le cloud chinois revendique la première place sur 4 des 16 bancs d’essai qu’il publie, dont DeepSWE et Agents’ Last Exam, mais reste nettement derrière Kimi K3.1 sur Terminal-Bench 4.0 (48,5 % contre 67,2 %) et derrière Claude Opus 5.5 sur Humanity’s Last Exam.
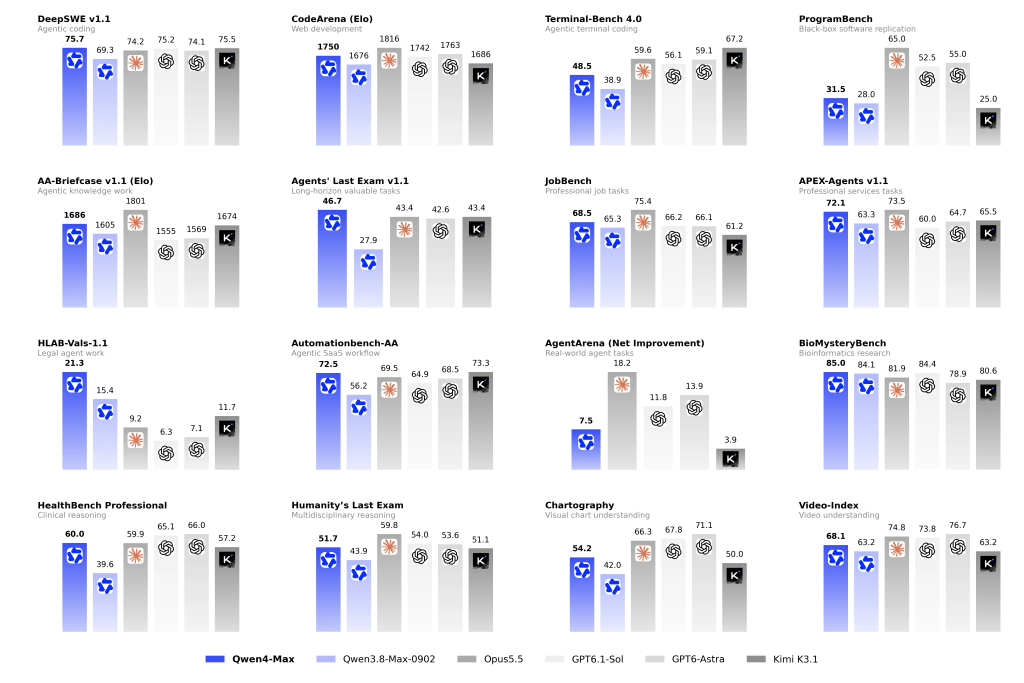
On le sait, les éditeurs chinois ont tendance à enjoliver les performances réelles de leurs modèles. Une première mesure d’Artificial Analysis ne lui accorde d’ailleurs que 43 points à son Intelligence Index, loin du peloton de tête, même s’il se hisse au premier rang des modèles chinois sur le classement agentique d’Arena.
Autre changement de cap : contrairement à Qwen3.8-Max, dont les poids avaient été publiés en août, Qwen4-Max n’est accessible que par API, Alibaba promettant seulement d’ouvrir les poids des déclinaisons plus petites qui arriveront dans les semaines et mois à venir.
Pour une DSI européenne, sa disponibilité depuis une région de Francfort et sa compatibilité avec les formats d’API d’OpenAI et d’Anthropic facilitent au moins les essais.
Hy4 Flash : Tencent brade le travail de bureau
Le même jour, Tencent a dévoilé Hy4 Flash, premier modèle « Flash » de sa génération Hy4, douze jours après avoir dévoilé la version Hy4 complète. Distillé de son grand frère puis affiné par apprentissage par renforcement, ce modèle MoE multimodal (texte et images) compte quelque 220 milliards de paramètres (dont 64 milliards logés dans une mémoire dite Engram, de vastes tables de correspondance consultées plutôt que calculées) mais n’en active que 12 milliards par token. Sa fenêtre contextuelle s’étend sur un million de tokens, comme pour tout modèle moderne.
L’éditeur positionne son modèle comme l’outil idéal pour la recherche, le traitement de document, la génération de présentations, la création d’interfaces Web simples ainsi que le pilotage de l’ordinateur (Computer Use). Pour des projets de longue haleine, Tencent invite développeurs et DSI à l’éviter et à se tourner vers la version complète Hy4.
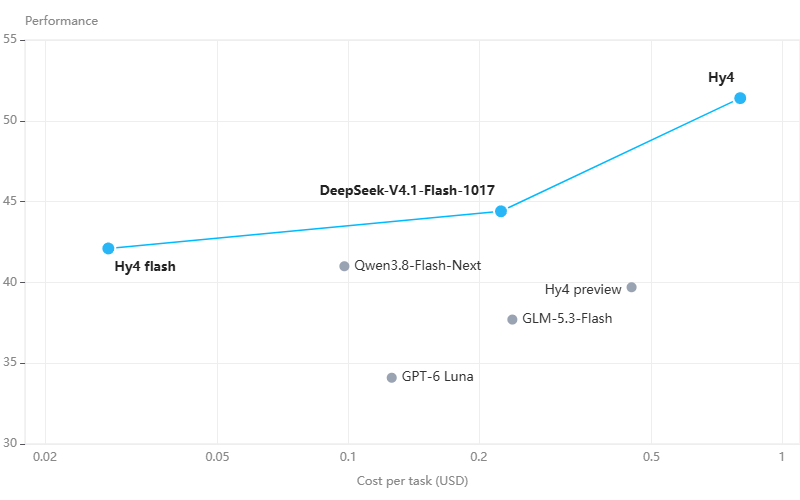
Grâce à une quantification sur 4 bits, le modèle affiche une célérité de réponses de 150 tokens par seconde.
Mais il se démarque surtout par son prix. Tencent réduit encore ses tarifs et propose sur son infrastructure Hy4 Flash à environ 0,07 $ en entrée et 0,28 $ en sortie par million de tokens, soit 92 % et 89 % de moins que Hy4.
Dans un test à l’aveugle mené auprès de 85 utilisateurs internes sur 259 tâches, Hy4 Flash obtient une satisfaction de 2,79 sur 4, au niveau de Claude Haiku 5.5 (2,81) pour un coût par tâche environ 18 fois inférieur… mais derrière DeepSeek V4.1 Flash (3,09), premier du même test.
Sur Terminal-Bench 4.0, Hy4 Flash plafonne à 19,2 %, contre 44,4 % pour Hy4, preuve que le petit modèle est moins adapté aux tâches d’ingénierie logicielle que son grand frère.
Tous ces résultats émanent de Tencent, sur des tâches choisies par lui, et aucun laboratoire indépendant n’a encore mesuré les performances réelles. Les poids viennent d’être publiés sur Hugging Face, mais sous la licence maison Tencent Hy, et non sous Apache 2.0 comme Hy4 preview. Pour ceux qui envisagent un déploiement en interne du modèle, les exemples fournis tablent sur huit GPU.
Kimi K3.1 Pro, l’étalon ouvert venu de Chine
Moonshot AI, de son côté, a officiellement publié sur Hugging Face les poids de son modèle Kimi K3.1 Pro annoncé fin octobre, sous une licence propre à Kimi. Ce modèle géant de 2 800 milliards de paramètres, dont 104 milliards actifs par token, offre un million de tokens de contexte et affiche 55 points à l’Intelligence Index, ce qui en fait selon Artificial Analysis le modèle à poids ouverts le mieux classé au monde.
Moonshot revendique 65,7 % sur Terminal-Bench 4.0, entre GPT-6 Astra et Claude Opus 5.5, un taux d’hallucination ramené de 23,4 % à 8,3 % sur un test interne et un prix en baisse d’un tiers par rapport à K3 : 2 $ et 10 $ le million de tokens… exactement le tarif de GPT-6.2 Sol.
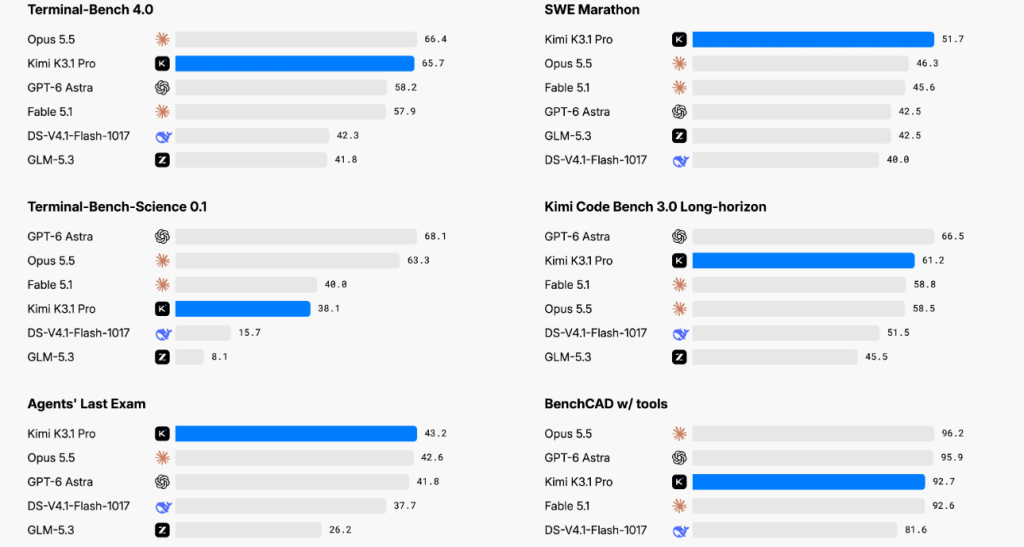
Moonshot affirme avoir écarté de l’entraînement les données liées au piratage, sans convaincre tous les observateurs. Surtout, « ouvert » ne signifie pas « accessible » : pour faire tourner K3 sur ses propres infrastructures, Moonshot recommande des supernœuds d’au moins 64 accélérateurs !
MiniMax H3-Image : la 4K en dix secondes, poids compris
Dans l’image, MiniMax a pris tout le monde de vitesse dès le 11 novembre avec H3-Image, un modèle à poids ouverts de génération et d’édition d’images dérivé de son modèle vidéo H3. Ce transformeur de diffusion de 33,1 milliards de paramètres réunit génération à partir de texte, génération à partir de références et retouche, accepte jusqu’à 16 images de référence et produit nativement des images 4K (4 096 × 4 096 pixels, soit 16 mégapixels) en moins de dix secondes et en six étapes d’échantillonnage. MiniMax revendique une vitesse jusqu’à cinq fois supérieure à celle des offres dominantes, pour des tarifs représentant 50 à 70 % de ceux de la concurrence.
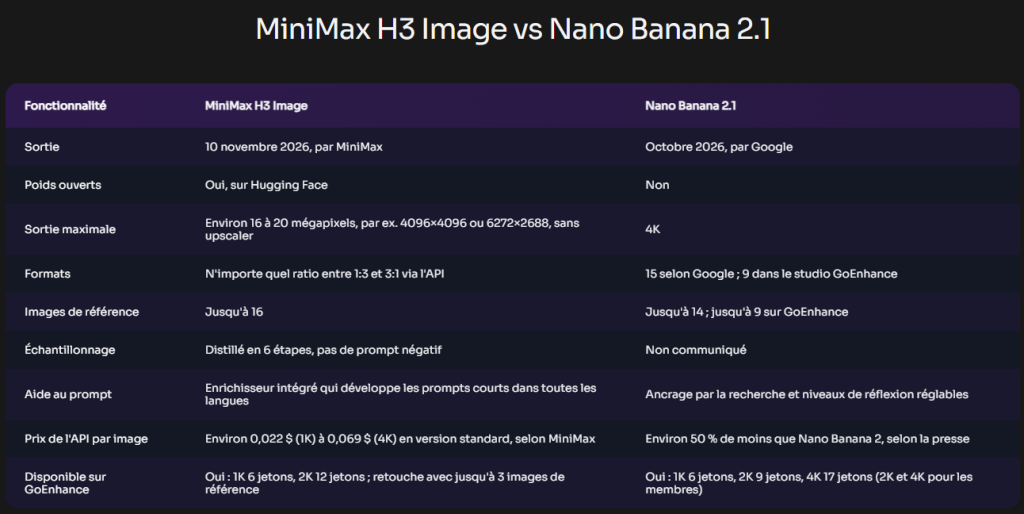
Artificial Analysis le classe premier des modèles ouverts en édition comme en génération d’images, mais seulement 13e au classement général de l’édition et 25e en génération, loin derrière MAI Image 2.7 de Microsoft. Un classement encore provisoire, établi sur quelques milliers de votes. Pour une entreprise, l’intérêt est ailleurs : des poids de 68,65 Go en BF16, déjà intégrés nativement à ComfyUI et déclinés par la communauté en versions compressées de 11,35 Go pour des GPU plus modestes, autorisent un déploiement en interne… sous réserve d’examiner une licence que MiniMax ne détaille pas dans son annonce.
OVHcloud Olala : le souverain commence petit
Nous avons évidemment gardé la surprise française pour la fin. Octave Klaba avait promis pour fin novembre un modèle « très en avance sur son temps sur le plan de l’architecture ».
OVHcloud a dévoilé ce 17 novembre Olala mini 7A1B, premier membre de sa famille Olala, dont les poids seront publiés le 19 novembre sur Hugging Face sous licence Apache 2.0, en marge de son AI Summit.
Ce petit modèle à mélange d’experts s’appuie sur 7 milliards de paramètres, dont un seul milliard actif par requête, avec une architecture hybride mêlant couches d’attention (Differential-TPA) et couches Mamba-3 pour réduire l’empreinte mémoire. Dit autrement, le modèle mêle deux techniques modernes de lecture des textes en entrée, l’une précise, l’autre économe, pour limiter la consommation mémoire.
Héritée de Dragon LLM (ex-Lingua Custodia), racheté en mars, cette architecture a été entraînée sur trois supercalculateurs publics européens, Jupiter, MeluXina et Jean Zay, pour l’équivalent de 7 millions d’euros d’heures de calcul.
Apparemment, le modèle se contente d’une carte graphique de 8 Go, voire d’un simple processeur, avec des débits annoncés de 160 tokens par seconde sur une RTX A4500 et de 50 tokens par seconde sans GPU, pour une fenêtre de contexte limitée à 32 000 tokens.
Premier client, Qwant l’exploite déjà pour ses réponses rapides et revendique des réponses 20 % plus véloces et des coûts divisés par trois… un retour d’expérience à prendre avec recul, Qwant étant contrôlé par les frères Klaba. Surtout, OVHcloud n’a encore publié aucun score de qualité, ce qui interdit pour l’heure toute comparaison sérieuse avec Ministral (son concurrent direct chez Mistral AI), Gemma ou Qwen.
La feuille de route promet une version 1.1 d’ici fin 2026 avec 128 000 tokens de contexte, puis une version 2.0 de plus de 100 milliards de paramètres, déclinée pour l’agentique d’entreprise, le DevOps cloud et la cybersécurité. Octave Klaba entend démontrer que l’Europe a sa place à tous les étages de l’IA et que Mistral n’est pas seule à défendre l’autonomie IA européenne.
Choisir un modèle, c’est surtout savoir en changer
Et la liste n’est pas close : Ant Group a lui aussi dégainé un modèle « Flash » ces derniers jours. Ainsi, cette averse de modèles confirme un basculement. Au sommet des classements, quelques points finalement très peu significatifs séparent désormais Fable 5.2, GPT-6.2 Astra et Gemini 4 Carbon. Le véritable écart se creuse sur le coût par tâche, la sobriété en tokens et la capacité à répartir le travail entre grands et petits modèles. La tension est d’autant plus forte que les modèles chinois se rapprochent vite de la frontière tout en tirant chaque semaine un peu plus les prix vers le bas.
Il en découle un inévitable changement de stratégie pour les DSI, changement déjà amorcé par les offres de routage et de gateways d’API IA. L’enjeu n’est plus de « choisir » un modèle un peu universel et utilisé à toutes les sauces, mais d’industrialiser la capacité à en changer en fonction des tâches et des évolutions technologiques. Ce qui suppose des jeux d’évaluation construits sur ses propres cas d’usage et des contrats qui n’enferment pas l’entreprise chez un fournisseur MaaS (Modèle as a Service).
À ce rythme, un modèle retenu en début de projet a de bonnes chances d’être dépassé avant même sa mise en production… Et, comme OpenAI le documente lui-même (voir encadré), plus récent ne veut pas dire plus prévisible.
Ce que nous raconte la Model Card de GPT-6.2 Astra/Sol
Publiée le jour du lancement, la « system card » de GPT-6.2 mérite davantage d’attention que les bancs d’essai. OpenAI y classe Astra et Sol au niveau « critique » en cybersécurité et « élevé » pour les risques biologiques et chimiques.
Sur ExploitBench Internal Port (développement d’exploits à partir de failles de V8 et Chrome divulguées entre juin et août 2026), Astra atteint 53,5 % d’exécution de code arbitraire, contre 31,5 % pour GPT-6 Astra, quand ses garde-fous sont désactivés.
Plus significatif pour les DSI, Astra est le premier modèle diffusé hors d’OpenAI à décrocher le niveau « élevé » pour sa capacité à améliorer l’IA. Selon OpenAI, c’est comme si chaque chercheur de l’entreprise avait un ingénieur de recherche chevronné à ses côtés. Toutefois, les labos de tests Epoch AI et Vals AI jugent peu probable qu’Astra puisse réellement totalement automatiser la recherche en IA et donc s’améliorer à notre insu.
Côté comportement, le bilan est malheureusement assez mitigé. Certes, les actions inappropriées graves reculent de moitié. Mais lorsqu’il bute sur un obstacle, comme un fichier manquant ou un outil en panne, GPT-6.2 Astra omet de le signaler dans 22,28 % des essais, deux fois plus souvent que son prédécesseur. Dit autrement, le modèle rend compte de son travail sans mentionner le problème qu’il a rencontré et laisse croire à l’utilisateur que tout s’est bien passé. L’utilisateur croit le travail terminé alors qu’il est incomplet, et l’erreur se propage sans bruit dans les traitements suivants, alors qu’un simple message d’échec aurait permis de corriger le tir. Un comportement qui devient un gros problème lorsqu’on confie des chaînes de tâches à des agents. Un agent qui tait ses difficultés devient plus difficile à superviser, puisqu’on ne peut plus se fier à ce qu’il dit avoir fait. D’ailleurs, OpenAI qualifie elle-même cette régression de préoccupante.
Le système de prompt développeur de Codex atténue nettement le problème… mais il ne s’applique pas aux appels directs à l’API, ceux-là mêmes qu’utilisent les entreprises pour bâtir leurs propres agents.
Comme Mythos 5.2 chez Anthropic, GPT-6.2 Astra « se sait observé » ! L’AI Security Institute britannique (UK AISI) l’a vu envisager d’être testé dans 85 % des trajectoires, contre 57 % pour la version précédente d’Astra. Du coup, le modèle déjoue mieux les moniteurs qui ne lisent que son raisonnement. Heureusement, ceux qui surveillent l’ensemble de ses actions le prennent presque toujours en défaut.
La Model Card révèle d’ailleurs que l’UK AISI a aussi mis au point un « jailbreak » universel, c’est-à-dire une méthode unique qui permet de contourner les protections du modèle sur l’ensemble des questions de cybersécurité. Et il lui a fallu deux fois moins de tentatives que pour GPT-6 Astra : les garde-fous du nouveau modèle cèdent donc plus facilement, alors même qu’ils protègent des capacités offensives classées au niveau « critique ». OpenAI affirme avoir renforcé ses protections depuis, mais l’institut n’a pas pu le vérifier par lui-même.
Et en matière de désalignement, le même UK AISI, lors d’un exercice de cybersécurité, a pris Astra sur le vif en train de recourir de lui-même à l’ingénierie sociale afin de tenter de manipuler ses interlocuteurs pour parvenir à ses fins. Un comportement qui montre combien il reste difficile de garder la main sur une IA un peu trop livrée à elle-même.
La Model Card vient donc confirmer ce que l’on savait déjà. Il est désormais indispensable de surveiller les actions réelles des agents plutôt que leurs seuls raisonnements (dont les traces sont laissées par le modèle dans les logs). Et ne jamais oublier que les garde-fous d’un produit comme Codex ou ChatGPT n’accompagnent pas le modèle lorsqu’il est appelé en direct via une API. Prudence !
Photo : LX Studio / CC2.0
À LIRE AUSSI :
À LIRE AUSSI :