Data / IA
Avec Large 4, Mistral AI s’invite dans le club très fermé des modèles ouverts à mille milliards de paramètres…
Par Laurent Delattre, publié le 07 octobre 2026
Surprise… Bonne surprise… Mistral AI dévoile en préversion Mistral Large 4, un modèle multimodal de 1 050 milliards de paramètres entraîné de zéro dans ses propres datacenters européens : une démonstration de force qui replace l’Europe dans la course aux très grands modèles ouverts, avec la cybersécurité pour cheval de bataille… mais sans pour autant combler l’écart avec les meilleurs modèles fermés américains.
C’est presque un grand Ouf de soulagement… Non, Mistral AI n’a pas abandonné la R&D sur les LLM frontière ! Oui, l’Europe est toujours dans la course, notamment celle des très grands modèles ouverts, ceux de plus de mille milliards de paramètres ! Mieux encore, elle est même aujourd’hui capable de les entraîner sur ses propres infrastructures souveraines.
Alors qu’Anthropic bouleversait l’écosystème frontière avec Mythos et Claude Fable, qu’OpenAI répliquait avec GPT-6 Astra, que SpaceXAI (devenu SpaceXSI pour faire plaisir à Trump) se réveillait avec Grok 4.7 et que la Chine multipliait les très grands LLM ouverts (avec Z.ai GLM-5.3, Moonshot Kimi K3, Alibaba Qwen3.8-Max ou DeepSeek V4), notre fleuron européen multipliait les petits modèles spécialisés (Medium 3.5, OCR 4.1, Mini Transcribe 2, Ministral, Codestral, Shieldstral, Moderation 2, Leanstral) et semblait avoir abandonné la frontière, allant même jusqu’à héberger GLM-5.3 sur sa propre infrastructure. Mais non ! Que nenni ! Et c’est tant mieux.
Car ce que Mistral AI a dévoilé ce mardi 6 octobre n’a rien d’un modèle de plus dans un catalogue déjà bien garni. Mistral Large 4 – « ML4 » officieusement, « le Chonk » (surnom affectueux donné aux très gros chats) très officiellement, à en croire un billet d’annonce qui ne manque pas d’autodérision – est tout simplement le plus grand et le plus capable des modèles jamais conçus par la start-up parisienne. Mieux encore, avec ses 1 050 milliards de paramètres, Large 4 est, à ce jour, le plus grand modèle d’IA publiquement documenté jamais entraîné de bout en bout par un acteur européen sur une infrastructure européenne.
Il est accessible dès aujourd’hui en préversion publique via l’API de Mistral Studio, et ses poids seront publiés d’ici la fin du mois. L’Europe disposera alors vraiment de son propre modèle ouvert de très grande taille.
Un mélange d’experts grand format
Sur le papier, et même si les Chinois et les Américains nous ont habitués au gigantisme ces derniers mois, la fiche technique de ML4 impressionne. Le modèle est nativement multimodal, bâti sur une architecture de mélange d’experts (MoE, Mixture of Experts) dite « granulaire » : 1 050 milliards de paramètres au total, dont seulement 49 milliards activés pour chaque jeton traité, auxquels s’ajoute un encodeur visuel de 1,6 milliard de paramètres.
Par rapport à Mistral Large 3, présenté en décembre 2025 avec 675 milliards de paramètres dont 41 milliards actifs, le saut est des plus significatifs : plus de 50 % de paramètres en plus, pour une hausse d’à peine 20 % des paramètres sollicités à chaque inférence. D’où un modèle qui embarque bien davantage de connaissances sans faire exploser le coût de calcul de chaque requête. La fenêtre de contexte atteint, elle, un million de jetons.
Surtout, ML4 corrige la principale faiblesse de son prédécesseur, qui était totalement dépourvu de mode de raisonnement natif. Le nouveau venu est un modèle hybride qui réunit dans un même ensemble les réponses directes, le raisonnement et les capacités agentiques, dans la logique d’unification déjà amorcée en mars avec Mistral Small 4, qui fusionnait les talents de Magistral, Pixtral et Devstral.
Pour bien des DSI, cette convergence n’a rien d’anodin puisqu’ils n’ont qu’un seul modèle à qualifier, à sécuriser et à superviser plutôt qu’une ménagerie de variantes spécialisées. Mistral revendique enfin une maîtrise native de plus de 160 langues, dont toutes les langues officielles de l’Union européenne, une part significative des données d’entraînement étant multilingue.
Entraîné à la maison
Mais l’avancée la plus marquante est ailleurs : ML4 a été entraîné de zéro sur 3 800 GPU NVIDIA Grace Blackwell installés dans les propres datacenters européens de Mistral, qui servent aussi la préversion publique.
Que de chemin parcouru en trois ans ! En 2023, Mistral 7B dépendait encore des instances H100 de l’américain CoreWeave et du supercalculateur Leonardo d’EuroHPC. Désormais, la start-up maîtrise toute la chaîne, des GPU jusqu’à l’API.
Certes, 3 800 GPU pèsent peu face aux centaines de milliers d’accélérateurs alignés outre-Atlantique. Mais c’est aussi tout le piquant de l’histoire : un acteur européen peut produire un modèle de mille milliards de paramètres compétitif avec une fraction des moyens de ses rivaux. L’entreprise voit d’ailleurs plus grand. Sa Série D de 3 milliards d’euros, bouclée en septembre sous la houlette de Samsung et qui la valorise plus de 21 milliards, doit financer une forte montée en capacité de calcul, jusqu’à 1 GW d’ici 2030.
Car pour une DSI, la souveraineté se joue aussi sur la continuité d’accès : perdre une capacité en plein incident devient en soi un risque de sécurité, souligne Mistral. Inutile de rappeler à quel point l’accès aux modèles les plus avancés se décide à Washington.
Mistral promet au contraire un déploiement opéré de bout en bout par ses soins et sous droit européen. Une fois les poids publiés, le modèle pourra en outre être hébergé dans les murs du datacenter de chaque entreprise.
Des scores à lire entre les lignes
Reste la question qui fâche : ML4 joue-t-il vraiment dans la cour des plus grands ? La réponse est nuancée. Mistral revendique des performances compétitives avec les meilleurs modèles ouverts de la planète et nettement supérieures à celles de tout modèle à poids ouverts conçu aux États-Unis ou en Europe. La formulation est révélatrice. Car si ML4 se contente de rivaliser avec les poids lourds chinois, c’est sur l’Occident qu’il revendique une vraie suprématie. Une façon de constater une fois de plus que le tempo des grands modèles ouverts se donne désormais à Pékin et à Hangzhou bien plus qu’à Paris ou dans la Silicon Valley. On ne parle là que de modèles ouverts en évitant soigneusement les comparaisons avec les modèles frontière propriétaires américains d’Anthropic, d’OpenAI, de Google et de SpaceXSI.
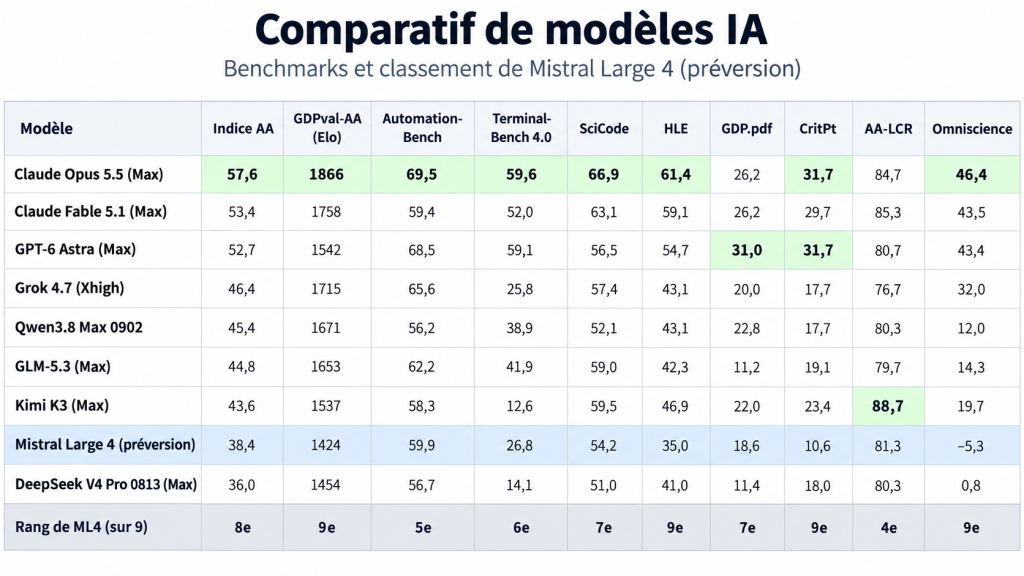
En code agentique, son score de 49,8 % sur le Coding Agent Index d’Artificial Analysis le place devant DeepSeek V4 Pro et Qwen3.8-Max, mais ces résultats, mesurés en privé avant l’ouverture publique du banc de test, ne sont pas encore reproductibles. L’évaluation humaine en aveugle menée avec Surge AI est plus parlante : ML4 y devance d’un cheveu GLM-5.3 et Kimi K3 (3,74 sur 5, contre 3,60 et 3,59), mais reste nettement derrière Claude Opus 5 (4,22), qui n’est pourtant plus la dernière version du modèle d’Anthropic.
Mistral précise par ailleurs que son cycle d’apprentissage par renforcement est toujours en cours et ne montre aucun signe de saturation. Les performances du modèle devraient donc encore progresser au fil des semaines.
La cybersécurité comme cheval de bataille
S’il est bon sur les tâches de codage et apparemment très pertinent sur les tâches agentiques, c’est surtout sur la cybersécurité que le dernier-né de Mistral se montre le plus offensif.
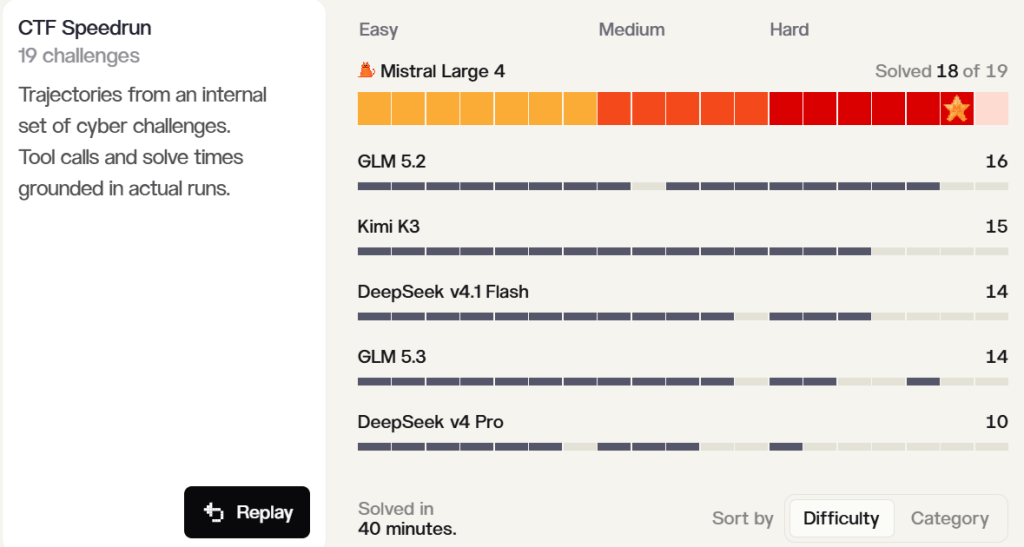
ML4 figure parmi les cinq meilleurs modèles du Cyber Index d’Artificial Analysis et signe le meilleur score mondial (82 %) sur un test consistant à reproduire puis corriger une vulnérabilité réelle. Un record d’autant plus facile que Claude Opus 5.5 ou GPT-6 Astra y obtiennent un score proche de zéro, tout simplement parce qu’ils refusent la tâche.
Mistral en fait même un argument commercial. Car défendre un logiciel suppose souvent de démontrer d’abord qu’une faille est exploitable. C’est exactement ce que les garde-fous des modèles fermés interdisent. De quoi faire mouche auprès des RSSI qui se sont déjà heurtés au refus d’un assistant en pleine réponse à incident.
Mais publier les poids d’un tel modèle, c’est mettre ces capacités à la portée des attaquants comme des défenseurs. Mistral met en avant un taux de refus des requêtes malveillantes supérieur à celui des autres modèles ouverts, et un « red teaming » (des tests d’attaque en conditions réelles) mené avec des partenaires triés sur le volet et des autorités étatiques.
Suffisant pour nous rassurer ? Pas vraiment. Une fois les poids du modèle dans la nature, un réentraînement ciblé suffit en théorie à neutraliser les garde-fous. Rappelons qu’Anthropic a préféré séparer Mythos (à l’accès très contrôlé et limité) et Fable (aux garde-fous pointilleux) pour restreindre l’accès aux capacités cyber les plus avancées à un tout petit groupe d’acteurs de la cyberdéfense.
Confinement contre diffusion : le Bureau européen de l’IA aura sans doute son mot à dire. Car, de par son ouverture, ML4 peut être aisément tuné et réentraîné, notamment depuis la plateforme Forge de Mistral qui simplifie ces opérations.
Ouvert ne veut pas dire à portée de main
Sans compter que chacun pourra aussi l’héberger, l’exécuter, voire le fine-tuner dans son propre datacenter. Certes, le « chacun » est un peu excessif. Encore faut-il pouvoir loger mille milliards de paramètres.
Même quantifiés sur 8 bits, les seuls poids dévorent plus d’un téraoctet de mémoire vive. Voilà qui mécaniquement réserve l’auto-hébergement aux grands comptes, aux administrations et aux fournisseurs de cloud.
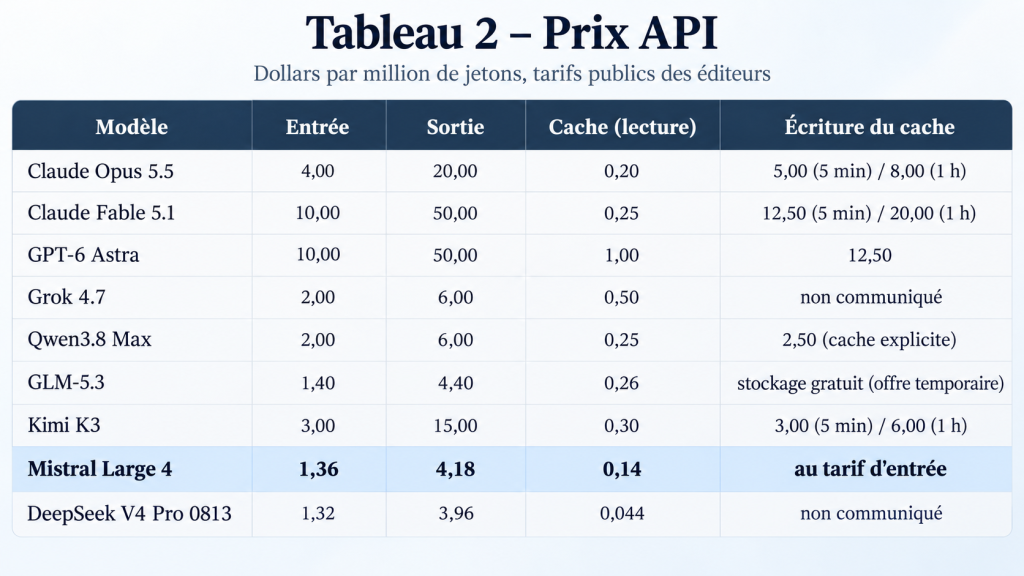
Pour les autres, la souveraineté, autrement dit la maîtrise numérique, passera par l’API de Mistral (1,36 dollar par million de jetons en entrée, 4,18 dollars en sortie), avec une inférence opérée en Europe. La publication des poids sert ici surtout de garantie de réversibilité. Un argument de poids face à des acteurs américains dont les conditions d’accès peuvent changer du jour au lendemain.
Pas encore de System Card mais déjà quelques détails
Mistral ne publie pas encore de véritable « System Card » comparable aux volumineux rapports de sécurité d’OpenAI ou d’Anthropic. La start-up livre toutefois plusieurs évaluations de sûreté dans son billet technique tout en mettant l’accent sur deux risques devenus centraux pour les agents IA : les injections de prompts et les usages cyber malveillants.
Sur le benchmark public B3 de Lakera, qui mesure la résistance aux attaques indirectes par prompt injection, Large 4 résiste à 93,3 % des attaques, un niveau significativement supérieur à celui des autres modèles open-weight.
Le modèle obtient aussi 1,691 sur 2 au KORA Benchmark, qui mesure la qualité et la responsabilité des réponses. C’est là encore le meilleur score parmi les modèles ouverts.
Plus intéressant au regard des capacités cyber particulièrement élevées de Large 4, le Français a confronté son modèle aux jeux de tests JailbreakBench, StrongREJECT et AgentHarm afin de vérifier sa propension à refuser les requêtes explicitement malveillantes. Selon Mistral, son taux moyen de refus y dépasse celui de tous les autres modèles open-weight évalués. C’est précisément l’équilibre recherché par Mistral : disposer d’un modèle suffisamment permissif pour reproduire une vulnérabilité, analyser un malware ou écrire une règle de détection sans pour autant transformer « le Chonk » en boîte à outils offensive prête à l’emploi pour tous les cyberattaquants. Mistral poursuit d’ailleurs actuellement le red teaming avec des spécialistes de la cybersécurité, des partenaires sélectionnés et des autorités publiques, certains ayant accès à une version moins modérée et dotée de capacités cyber étendues.
Le grand modèle qui donne un sens aux petits
Reste le paradoxe soulevé en ouverture. Pourquoi avoir multiplié les petits modèles pendant que les rivaux s’écharpaient sur la frontière ? Parce que les deux démarches se complètent : ML4 servira de fondation à une nouvelle génération de modèles spécialisés, le grand modèle jouant le rôle de « professeur » pour des modèles plus compacts et moins coûteux à exploiter. Et comme il a été entraîné avec l’environnement que Mistral propose à ses clients (le service Forge), les outils qui ont bâti le modèle phare serviront aussi à l’adapter à leurs métiers.
Au-delà des promesses, ML4 n’est encore qu’une préversion : poids non publiés, licence non précisée, scores de code à vérifier. Mais l’essentiel est ailleurs. En entraînant de zéro un modèle de mille milliards de paramètres dans ses propres datacenters, Mistral prouve que l’Europe dispose désormais non seulement des talents, mais aussi des infrastructures pour produire de très grands modèles. La frontière fermée, elle, reste hors d’atteinte. Pour combien de temps ? C’est tout l’enjeu des 3 milliards d’euros fraîchement levés.
À LIRE AUSSI :
À LIRE AUSSI :