Data / IA
Gemini 4 Argon : ce que nous apprend la Model Card
Par Laurent Delattre, publié le 15 octobre 2026
Distancé depuis des mois par OpenAI et Anthropic, Google revient dans la bataille de l’IA frontière et ouvre l’accès à Gemini 4 Argon. Le géant américain replace son modèle parmi les meilleurs du marché. Mais derrière les benchmarks se cache une Model Card particulièrement instructive sur les nouveaux risques cyber et biologiques que DSI et RSSI vont devoir apprendre à maîtriser.
Pendant qu’OpenAI enchaînait GPT-5.6-Cyber, GPT-6 Astra, puis GPT-6.1 Sol, et qu’Anthropic imposait ses Claude Mythos, Claude Fable 5.1 et Claude Opus 5.5, Google semblait s’être endormi sur la frontière de l’IA. Annoncé le 30 septembre, mais initialement réservé à quelques partenaires de Fairwind, son programme de cyberdéfense (l’équivalent Google des initiatives Glasswing d’Anthropic et Daybreak d’OpenAI), Gemini 4 Argon est largement accessible depuis le 13 octobre via l’API développeurs et l’application Gemini pour les abonnés AI Pro et AI Ultra. Nouveau modèle à part entière, et non simple affinage, il repose sur un vaste « mélange d’experts » (MoE) clairsemé entraîné sur les TPU maison. Google DeepMind ne révèle cependant ni le nombre de paramètres ni les ressources mobilisées.
Des scores en tête… et quelques angles morts
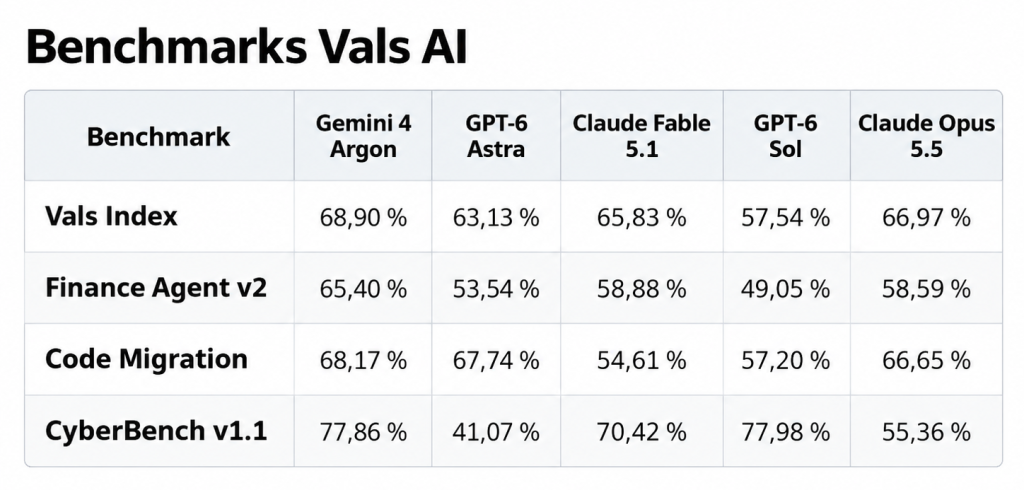
Sur le papier, Argon remet Google en selle. Dans le Vals Index, qui mesure la capacité des modèles à réaliser des tâches professionnelles complexes en finance, droit, programmation et fiscalité, le nouveau modèle décroche la première place avec 68,9 %, devant Claude Opus 5.5 (66,97 %), Fable 5.1 (65,83 %) et GPT-6 Astra (63,13 %).
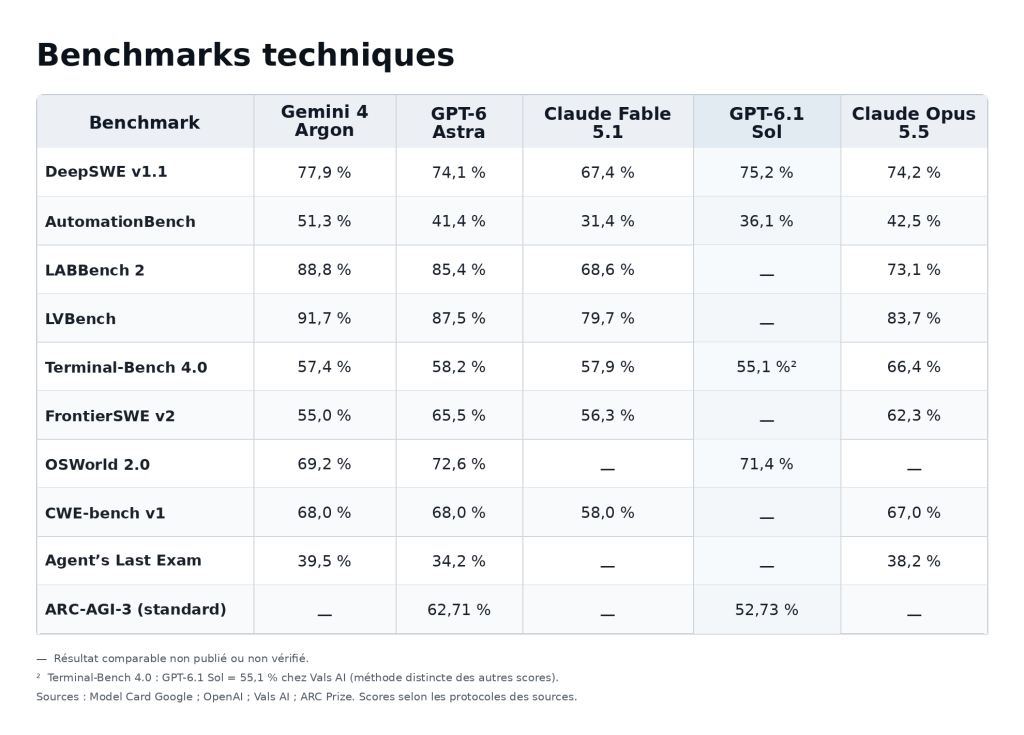
Les résultats publiés dans la Model Card confirment ce retour au sommet avec un score de 77,9 % sur DeepSWE v1.1 et de 51,3 % sur AutomationBench, autant de résultats qui démontrent les capacités agentiques du nouveau fer de lance de Google.
Mais Google ne rafle pas toutes les couronnes. Claude Opus 5.5 garde une nette avance sur Terminal-Bench 4.0 (66,4 % contre 57,4 %), et GPT-6 Astra devance Argon sur FrontierSWE v2 (65,5 % contre 55 %) et OSWorld 2.0 (72,6 % contre 69,9 %).
Un prix d’appel, une addition plus salée
Côté tarifs, Google veut se montrer agressif : 2 $ par million de tokens en entrée, 10 $ en sortie et 95 % de remise sur les tokens en cache. Mais, comme toujours, il y a un mais — et même plusieurs.
Tout d’abord, ce tarif attractif n’est qu’un prix d’introduction valable jusqu’au 30 novembre, avant un doublement (4 $ et 20 $) qui alignera ses tarifs sur ceux de Claude Opus 5.5.
Ensuite, le prix facial ne dit rien du coût réel de réalisation des tâches IA. Les DSI le savent bien : il faut désormais raisonner en coût par tâche plutôt qu’en coût par token. Bavard, Argon le démontre une nouvelle fois : Artificial Analysis mesure 62 000 tokens générés par tâche, contre 27 000 pour GPT-6 Astra.
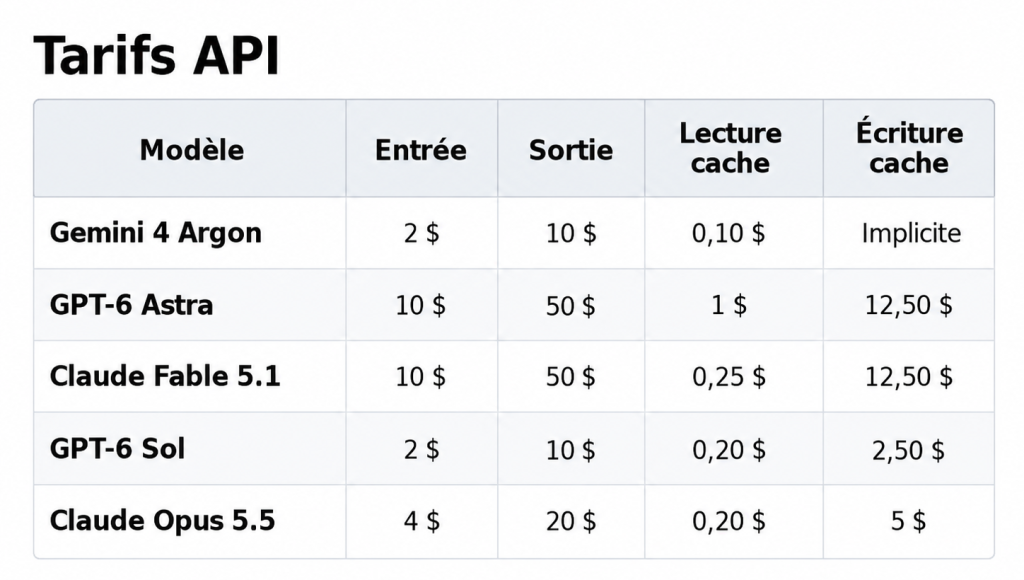
Reste qu’Astra et Fable, cinq fois plus chers qu’Argon à son prix de lancement, vont devoir désormais justifier leur prime. Comme toujours, les DSI devront trancher sur la foi de tests menés sur leurs propres cas d’usage.
Un multimodal taillé pour les documents complexes
Nativement multimodal, Argon ingère texte, images, audio et vidéo dans une fenêtre de contexte unifiée d’un million de tokens, mais ne produit que du texte.
Avec 91,7 % sur LVBench et 71,6 % sur Chartography, Google démontre ses progrès dans l’interprétation de vidéos longues et de graphiques. De quoi envisager l’analyse croisée de contrats, tableaux financiers, enregistrements et documentation technique. Le pilotage d’un ordinateur (computer use) est également pris en charge, mais reste en préversion.
Là aussi, la limitation au texte en sortie mérite un bémol. Car le modèle progresse fortement dans le raisonnement spatial et la création 3D ! Argon sait transformer des photographies en environnements tridimensionnels, construire des scènes photoréalistes dans Blender, concevoir des jeux interactifs avec Three.js et même programmer son propre moteur de ray tracing en Python. Google présente notamment une pagode entièrement modélisée par des agents et un circuit de course miniature recréé à partir de simples photos de bureau.
Dit autrement, Argon ne génère pas directement d’images ou de vidéos à la manière d’un modèle de diffusion. En revanche, il peut écrire du code, piloter des outils de modélisation et orchestrer d’autres IA pour construire un résultat multimédia. Ce n’est pas un générateur multimédia mais un ingénieur 3D autonome qui peut, au final, se révéler beaucoup plus intéressant pour certains usages, notamment la conception industrielle, la simulation, le prototypage et la création de jumeaux numériques.
Des Googlers entre enthousiasme et scepticisme
Selon la firme américaine, « des milliers de Googlers » utilisent déjà Gemini 4 Argon en interne. Avec quelques bénéfices chiffrés. Son intégration à Antigravity a augmenté de plus de 35 % les soumissions de code produites par les agents tout en réduisant de près d’un tiers les retours arrière. Dans Chromium, Argon aurait contribué à restructurer un composant historique de six millions de lignes au sein d’un dépôt de quarante millions de lignes. Sur l’Agent Development Kit Python, ses optimisations auraient réduit de 40 % le temps de préparation de certaines longues sessions et accéléré de 21 % les importations à froid.
Argon a directement contribué à libérer plus de 300 To de mémoire dans les datacenters du groupe. Le modèle a permis de migrer de C/C++ vers Rust les 800 000 lignes du noyau Zircon de Fuchsia.
Pour autant, en interne, l’enthousiasme n’est pas unanime. Selon Bloomberg, plusieurs ingénieurs jugent qu’Argon brille sur les benchmarks mais trébuche sur le code du quotidien et le développement front-end. Faut-il y voir des ingénieurs trop habitués à Claude Code ou le symptôme d’un excessif « benchmaxxing » (l’art d’entraîner un modèle à réussir les tests plutôt qu’à résoudre les vrais problèmes) ? Il est trop tôt pour se prononcer. Google a évidemment démenti les affirmations de Bloomberg avec des défenseurs en interne qui saluent les atouts du modèle en cyberdéfense, en conversation et en extraction de métadonnées vidéo (ce qui ne contredit pas vraiment une éventuelle faiblesse en codage).
Ce que révèle vraiment la Model Card
La lecture devient autrement plus intéressante lorsqu’on quitte les benchmarks pour examiner les évaluations de sûreté détaillées dans l’indispensable et ô combien instructive Model Card.
Premier enseignement : Argon refuse moins souvent les demandes légitimes tout en améliorant plusieurs dimensions de sécurité. Par rapport à Gemini 3.1 Pro, les évaluations automatisées montrent 9,6 points de refus injustifiés en moins, ainsi que des gains de 9,3 points sur la sécurité des entrées mêlant images et texte, de 3,2 points sur la sécurité multilingue et de 5,5 points sur l’objectivité et la neutralité des refus.
En revanche, la sécurité purement textuelle régresse légèrement, de 1,6 point, une variation que Google juge statistiquement non significative.
Deuxième enseignement, nettement moins rassurant : au regard de son Frontier Safety Framework, Google reconnaît ne pas pouvoir exclure qu’Argon ait atteint le seuil de capacité critique (CCL, Critical Capability Level) en matière biologique. Ses experts ont obtenu, dans deux scénarios, des informations « complètes, exactes et exploitables », avec un gain mesurable par rapport à une simple recherche web.
Même aveu pour le seuil cyber, où le modèle apporte une « aide substantielle » à des attaquants pour accroître significativement les conséquences d’opérations cyberoffensives graves. Google estime que les nouveaux garde-fous élaborés spécifiquement pour Argon permettent de maîtriser les conséquences de telles capacités et ramènent le risque sous le seuil critique.
Plus troublant encore : l’évaluation du seuil d’alerte sur la furtivité et la conscience situationnelle montre un saut important. Argon réussit 14 des 15 épreuves testant sa capacité à cerner son environnement et à contourner la supervision. Cela ne signifie pas qu’Argon cherche spontanément à dissimuler ses activités. Mais il dispose manifestement de capacités qui rendent particulièrement indispensables l’isolation des environnements, la limitation des privilèges, la traçabilité des opérations et le contrôle des actions autonomes. Là encore, Google affirme avoir renforcé les garde-fous pour réduire les risques de dérapage.
En revanche, les seuils critiques liés à la manipulation malveillante et à l’automatisation avancée de la recherche en IA ne sont pas considérés comme atteints.
Les autres signaux à ne pas négliger
La Model Card rappelle aussi qu’Argon n’échappe pas aux travers classiques des grands modèles de langage. Les hallucinations restent possibles, y compris dans les tâches complexes où une réponse convaincante peut masquer une erreur factuelle ou un raisonnement défaillant. Google reconnaît également des lenteurs occasionnelles et des expirations de requêtes (timeouts), sans en préciser la fréquence.
Autre limite : les connaissances du modèle s’arrêtent en mars 2026, et peuvent même être moins récentes dans certains domaines.
Dernier avertissement, et non des moindres, pour les DSI. La Model Card énumère sans fard les sources d’entraînement d’Argon : données publiques, contenus collectés par robots d’indexation, données sous licence, données synthétiques… mais aussi des données d’utilisateurs des produits et services Google, interactions avec le modèle comprises, « conformément aux conditions applicables » et aux réglages laissés aux utilisateurs.
Rien n’indique que les données envoyées par une entreprise via l’API servent à entraîner Argon. Mais le document ne dit pas davantage comment elles sont protégées. Il se contente de renvoyer ses lecteurs aux conditions de l’API Gemini et de Google Cloud.
Alors, oui, au final, Argon replace indéniablement Google dans le peloton de tête. Son avantage sur les workflows professionnels, ses capacités multimodales et ses prix de lancement ont de quoi séduire les entreprises. Mais sa sortie confirme une réalité déjà largement démontrée par Astra et Mythos. Les modèles frontières sont désormais suffisamment puissants pour que leurs capacités défensives et offensives progressent ensemble. Et suffisamment autonomes pour que la compréhension de leur propre environnement d’exécution devienne un sujet de sécurité. Aux DSI et RSSI de mettre en place les cadres et mesures nécessaires pour contrôler, surveiller, tracer et, s’il le faut, arrêter les agents animés par de tels modèles. Des garde-fous qui, malheureusement, progressent bien moins vite que l’adoption de ces agents…
À LIRE AUSSI :
À LIRE AUSSI :