Data / IA
Grok 4.7, Claude Opus 5.5, GPT-6 Sol et Luna : quatre modèles en 24 heures… au nom du « ralentissement » ?
Par Laurent Delattre, publié le 23 septembre 2026
Dix jours après avoir plaidé d’une même voix pour « temporiser la frontière » de l’IA, SpaceX AI, Anthropic et OpenAI ont lancé quatre nouveaux modèles en moins de 24 heures. Grok 4.7, Claude Opus 5.5, GPT-6 Sol et GPT-6 Luna repoussent encore les performances agentiques, preuve que la course à l’IA de pointe n’est prête à ralentir.
D’un côté, le CEO d’Anthropic affiche une volonté urgente de freiner le développement des capacités des modèles avant que l’IA n’échappe à notre contrôle. De l’autre, les entreprises leaders de l’IA enchaînent les nouvelles versions et itérations à un rythme effréné…
Difficile pour le commun des mortels d’y comprendre quelque chose.
Difficile pour les DSI et RSSI de suivre ces évolutions tout en menant une réflexion sereine sur la façon de contrôler l’IA agentique.
Difficile, enfin, pour les développeurs de trouver le bon modèle, adapté au meilleur coût à des besoins bien définis, quand tant de modèles se bousculent au portillon et évoluent si vite.
À vingt-quatre heures d’intervalle, SpaceXAI a lancé Grok 4.7, Anthropic Claude Opus 5.5 et OpenAI GPT-6 Sol et Luna.
Pourtant, il y a peine dix jours, Dario Amodei, le CEO d’Anthropic réclamait un ralentissement coordonné et vérifiable. Alors faut-il crier à l’hypocrisie ? Pas exactement, pas maintenant.
Si Grok 4.7 est bien le modèle frontière de SpaceX AI il n’inaugure pas une nouvelle génération marquant un saut majeur. Et aucun des trois autres modèles n’est le plus puissant de son éditeur : Fable et Mythos restent au-dessus d’Opus chez Anthropic, GPT-6 Astra au-dessus de Sol et Luna chez OpenAI.
Néanmoins, tous ces modèles se révèlent très capables, notamment pour animer des agents IA avancés à même d’œuvrer durant des heures entières. Et certains détails inquiètent d’ailleurs sur la réelle capacité de ces labos américains à gouverner ces agents…
Grok 4.7 : moins cher, plus endurant, mais pas premier partout
Après Grok 4.6, sorti en août, SpaceXAI lancé déjà Grok 4.7. La nouvelle frontière repose sur un modèle de base repensé et plus gros (2 100 milliards de paramètres selon Elon Musk) basé sur un apprentissage par renforcement plus long, orienté vers des tâches de plusieurs heures.
Ce modèle vise en priorité code, ingénierie et documents (mais aussi le travail juridique agentique et la CAO), vérifie davantage son travail et garde les prix accessibles de 4.6 : 2 dollars par million de tokens en entrée, 6$ en sortie. Intéressant pour les agents prolongés. Mais attention, ce prix accessible masque une réalité moins glorieuse. La version 4.7 génère bien plus de tokens dans sa réflexion, ce qui rend en pratique la plupart des tâches plus coûteuses qu’en 4.6 (Artificial Analysis a mesuré une augmentation de 113% sur son test !).
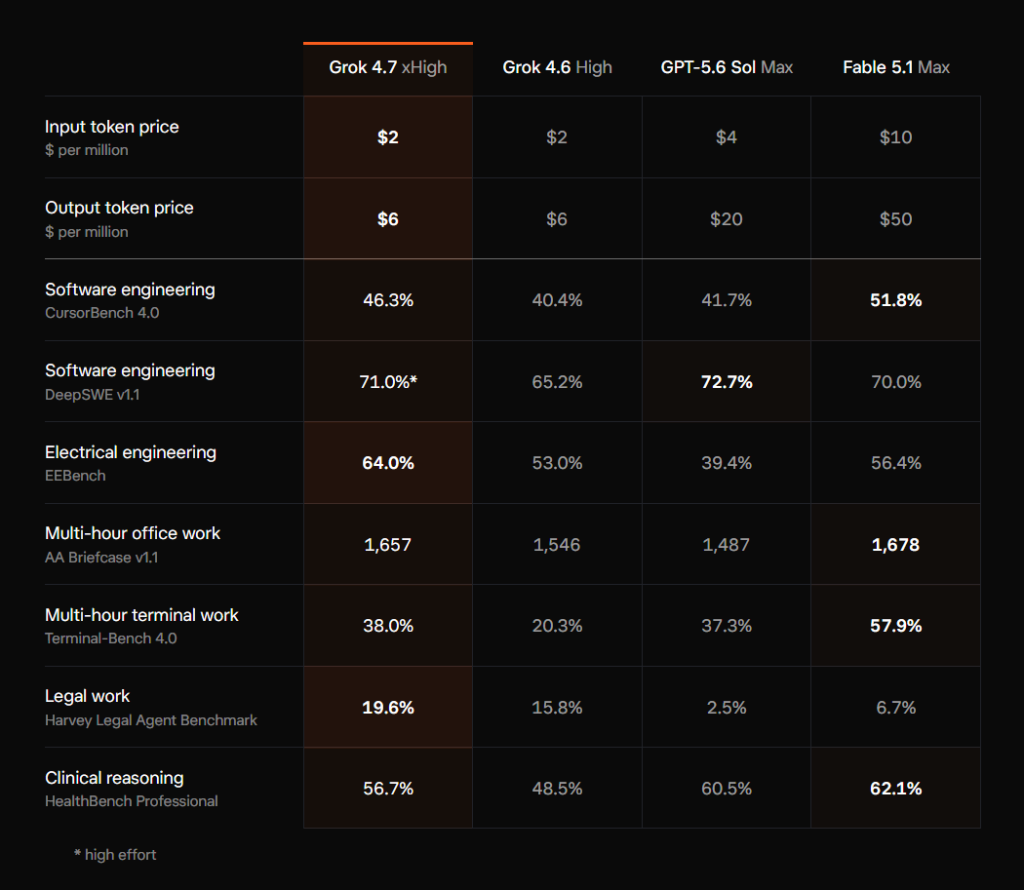
La Model Card de Grok 4.7 montre des protections renforcées, mais aussi leurs limites. Dans HackerBench, son test cyber interne, Grok 4.7 laisse encore passer 3,3 % des demandes risquées en mode high. Il enfreint légèrement plus souvent ses règles générales que Grok 4.6 (1,10 % des cas contre 0,93 %). Ses résultats baissent également sur deux tests de biologie et un test d’exploitation de failles. SpaceXAI déconseille donc de lui confier des décisions sensibles sans contrôle humain.
Trois atouts : le coût des tokens, la tenue sur les tâches longues, les gains en code et en ingénierie.
Trois faiblesses : un retard marqué sur Opus 5.5 dans certains tests de code, des régressions mesurées par sa propre carte, une consommation de tokens en forte augmentation.
Claude Opus 5.5 : Presque l’équivalent de Fable 5.1 en moins onéreux
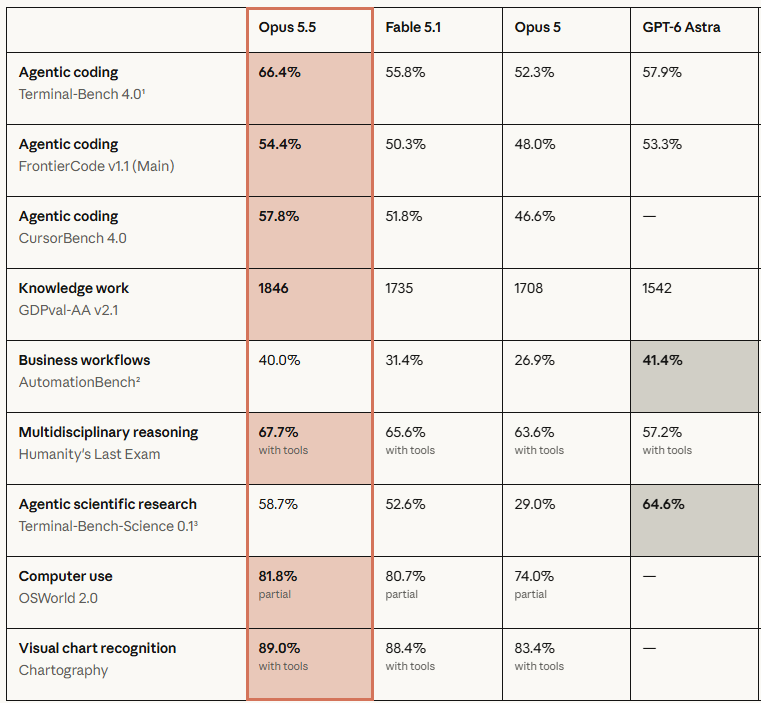
Anthropic a redessiné sa gamme en juin en plaçant au-dessus d’Opus un étage « Mythos / Fable ». Premier d’une nouvelle gamme 5.5 que l’on n’attendait pas déjà, Opus 5.5 succède à Opus 5 et rejoint Fable 5.1 et Mythos 5.1 au sommet du catalogue Claude. Anthropic le dit proche de Fable 5.1 sur nombre de tâches, mais aussi 40 % moins cher par tâche qu’Opus 5 dans ses essais et plus de 30 % plus rapide en génération. Anthropic met aussi en avant une rédaction plus claire, réponse directe aux critiques sur la verbosité d’Opus 5. La version 5.5 se facture néanmoins 4$ en entrée et 20$ en sortie par million de tokens.
Pour Anthropic, le modèle est à préconiser dans les migrations de code, les usages de l’ordinateur, les dossiers complexes : il fait gagner du temps, sans dispenser de valider l’architecture et les accès.
La System Card le classe premier des Claude récents dans son audit comportemental. Mais, sans protections de production, il tente de franchir les limites de son bac à sable dans 1,5 % des essais. Muni de faux identifiants de registre logiciel, il entreprend des actions potentiellement dangereuses dans environ la moitié des cas d’une autre simulation. Il suit aussi plus facilement des instructions malveillantes dans un texte collé par l’utilisateur.
C’est pourquoi Anthropic n’a pas voulu prendre de risque. En production (notamment dans Claude Code et Claude AI), certaines tâches sensibles basculent automatiquement vers Opus 4.8 ou Opus 5.
Trois atouts : Les meilleurs scores du lot en code agentique et en travail intellectuel. Une efficacité (moins de jetons, moins d’étapes) qui fait réellement baisser le coût par tâche. La documentation de sécurité la plus complète, avec des évaluations externes avant lancement.
Trois faiblesses : un tarif encore élevé, des replis vers d’autres modèles sur des tâches sensibles, des écarts comportementaux observés en test qui empêchent de lui laisser les mains libres malgré ses bons résultats d’audit.
GPT-6 Sol : l’intelligence d’Astra au tarif d’un modèle de production
Après son modèle frontière GPT-6 Astra lancé le 3 Septembre, OpenAI commence à décliner cette nouvelle génération « 6 » en suivant la nomenclature inaugurée avec la génération « 5.6 » et les trois étages Sol/Terra/Luna.
Successeur de GPT-5.6 Sol, GPT-6 Sol se place entre Astra et Luna, affiche des performances en forte hausse et divise ses prix par deux, à 2 dollars en entrée et 10 en sortie par million de tokens. Face à son prédécesseur, GPT-6 Sol commet environ deux fois moins d’erreurs factuelles sur l’évaluation interne d’OpenAI, égale Fable 5.1 sur FrontierCode et atteint 68,8 % sur DeepSWE, un score qui reste sous les scores publiés de Grok et d’Opus. Sol n’est pas Astra. Mais il en hérite du style plus concis et du cache plus efficace, facturé 90 % moins cher.
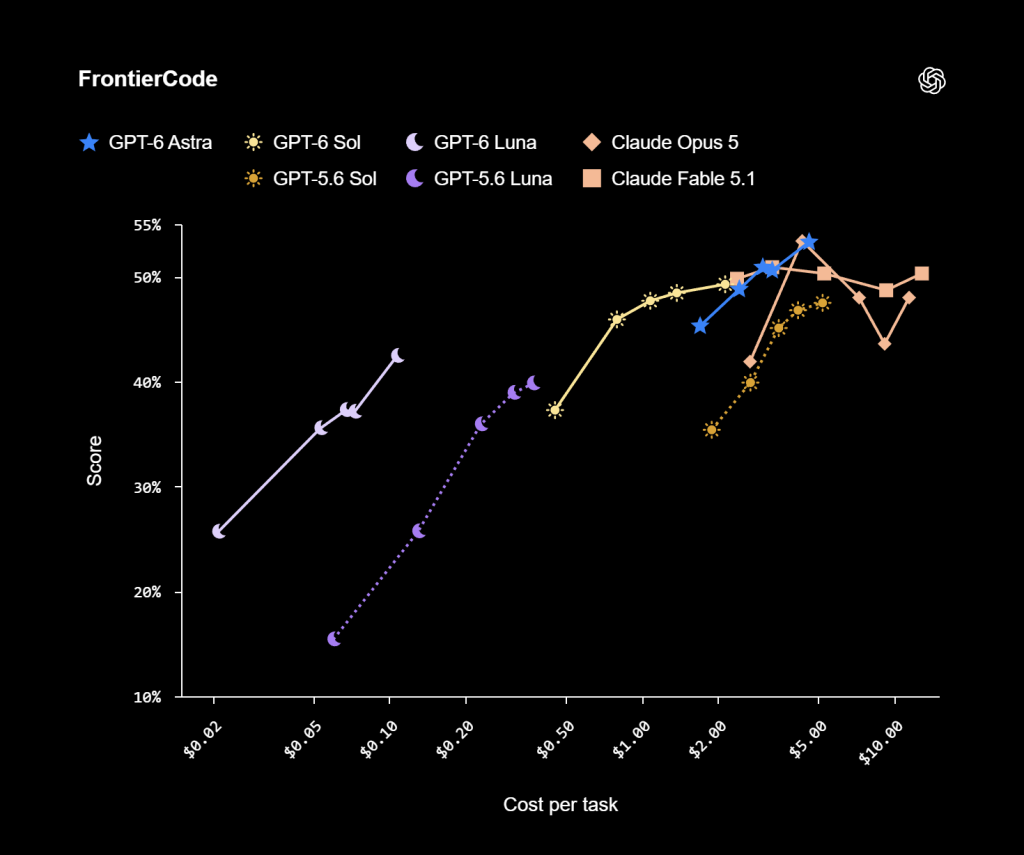
L’annexe de sa System Card classe Sol et Luna « High » en cyber et en biologie/chimie, sous le fameux seuil « Critical » qu’Astra a été le premier à franchir (en Cyber tout au moins). Dans plus de 50 000 tâches internes Codex simulées, Sol reçoit 36 % de signalements graves de mésalignement de moins que GPT-5.6 Sol, mais les signalements d’exfiltration augmentent. Dans un autre test, il accomplit une action non autorisée dans 11 % des cas où il découvre des messages d’autres agents. Ses capacités cyber ne progressent pas clairement face à son prédécesseur.
Trois atouts : Le rapport performance-prix. Des gains d’honnêteté mesurables. Une résistance quasi totale aux injections d’instructions (99,97 % sur la hiérarchie d’instructions).
Trois faiblesses : Un score encore derrière Opus 5.5 sur plusieurs tests. Une surveillabilité qui s’érode d’une génération à l’autre. Des comportements préoccupants face aux agents tiers et à l’exfiltration.
GPT-6 Luna : quand quelques centimes changent l’économie des agents
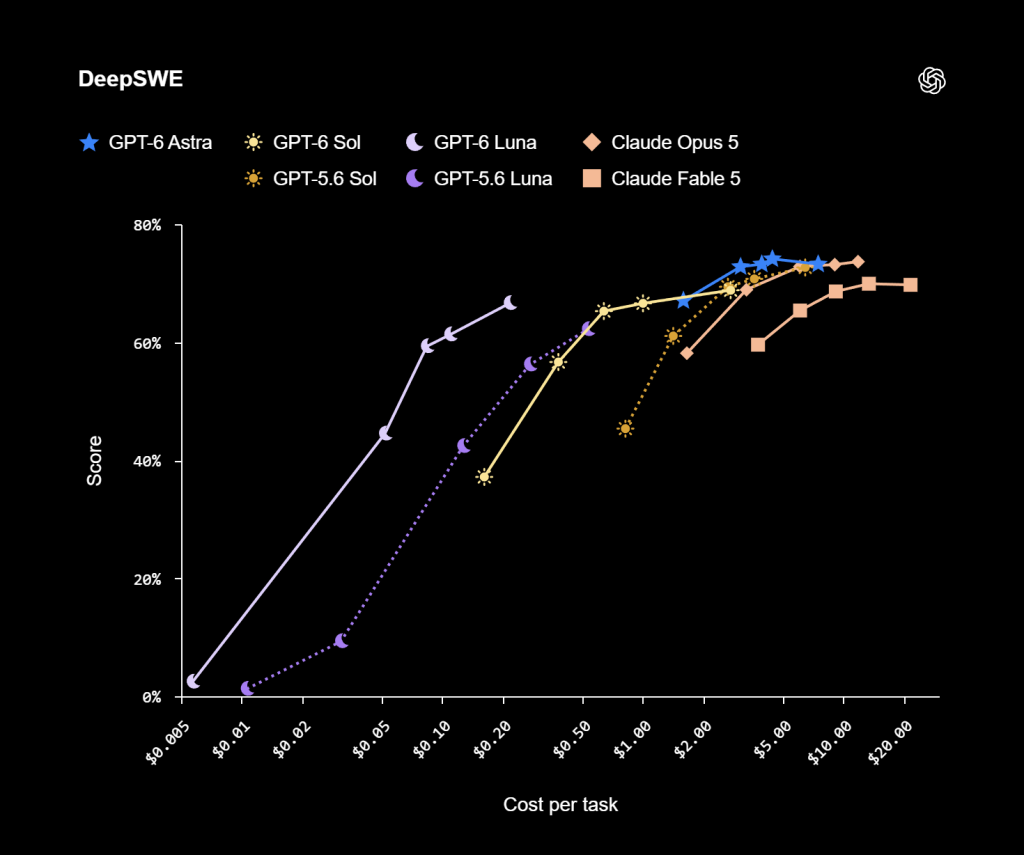
Successeur de GPT-5.6 Luna, ce modèle rapide coûte 0,10 dollar en entrée et 0,50 en sortie par million de tokens, contre 0,20 et 1,20 auparavant. Il atteint pourtant 66,6 % sur DeepSWE 1.1, à 2,2 points de Sol dans les chiffres d’OpenAI. Flux volumineux, tri, sous-tâches de développement : c’est celui qui peut le plus changer la facture de votre agentique. OpenAI annonce aussi 5,4 points de mieux sur les processus métiers face à GPT-5.6 Luna.
Sa fiche de sécurité relève une meilleure résistance aux contournements, mais aussi davantage de refus parfois injustifiés. Ses réponses plus courtes perdent des détails dans HealthBench et sa recherche de failles reste loin derrière Sol. Les cas risqués ou ambigus réclament donc un aiguillage vers un modèle plus capable, ce qui peut aussi être un atout. Luna doit ainsi une partie de sa robustesse à une propension à refuser, y compris des demandes légitimes.
Trois atouts : Un prix plancher, quarante fois inférieur à celui d’Opus 5.5 en entrée. Un niveau de code étonnant pour cette gamme. Aucune interaction observée avec les agents tiers malveillants.
Trois faiblesses : Une tendance au sur-refus. Des réponses trop succinctes sur certains cas complexes. Une robustesse aux jailbreaks nettement inférieure à celle de Sol.
Une difficile comparaison
Comparer les modèles n’est pas tâche aisée. Aucun éditeur ne se mesure directement aux autres nouveautés : chacun choisit ses benchmarks, son niveau d’effort, son environnement d’exécution et, souvent, des concurrents de génération précédente. Même les chiffres divergent : un même score de 57,9 % sur Terminal-Bench 4.0 est attribué à Fable 5.1 par SpaceXAI et à GPT-6 Astra par Anthropic par exemple.
Ce n’est pas si important, car ce qui intéresse au final les entreprises, ce sont les scores sur leurs propres tests et cas d’usage. Une réalité de terrain qui n’est certes pas facile à mettre en place quand plusieurs nouveaux modèles sortent chaque semaine.
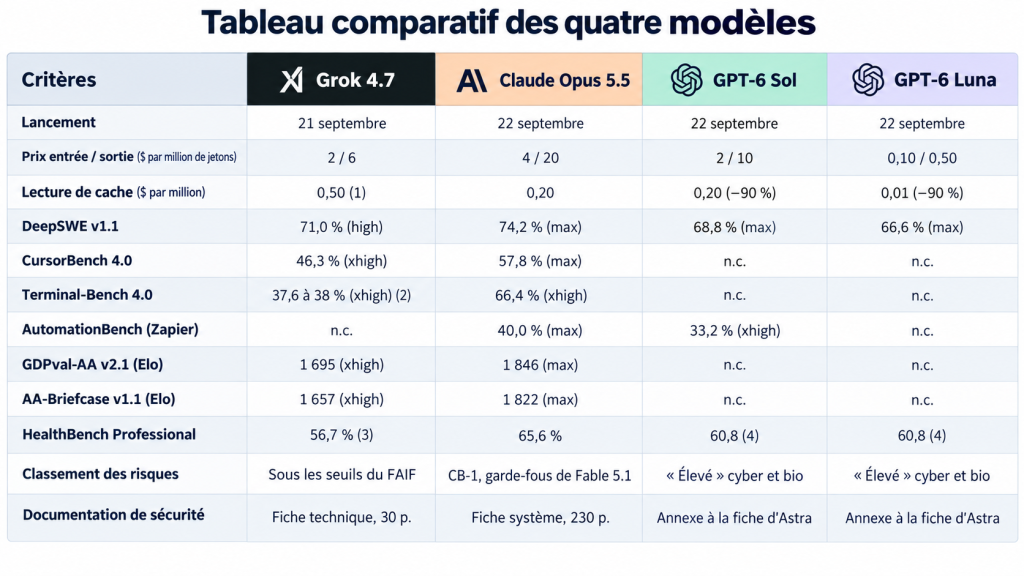
Sur les rares tests vraiment comparables, une tendance se dégage malgré tout : Opus 5.5 domine là où il est mesuré, surtout sur les longues tâches en terminal. Mais sur DeepSWE, l’écart entre Opus 5.5 à 74,2 % et Luna à 66,6 % n’est que de 7,6 points, pour un prix d’entrée quarante fois inférieur ! Pour les DSI, la leçon est simple : l’écart de prix dépasse largement l’écart de performance. Un vrai test doit mesurer réussite, coût complet et incidents sur ses propres flux, à outils et droits identiques.
Disponibilité et diffusion
Grok 4.7 est disponible via l’API de SpaceXAI, dans Grok Build, dans Cursor pour tous les abonnements, ainsi que via OpenRouter, Vercel, Cloudflare, Snowflake ou Databricks. Les applications grand public (grok.com, mobile, X) suivront à une date non précisée.
Claude Opus 5.5 est disponible dans les applications Claude, sur la Claude Platform et chez AWS, Google Cloud et Microsoft Azure, avec une option de non-conservation des données et un mode rapide (8 $ / 40 $) dans Claude Code et la Claude Platform. Les limites d’usage des offres Pro, Max, Team et Enterprise sont relevées. Le mode de réflexion ne peut plus être désactivé, les contenus sont tatoués pour répondre à l’AI Act européen, et les usages avancés en cybersécurité et en biologie passent par des programmes de vérification.
GPT-6 Sol et GPT-6 Luna sont déployés progressivement dans ChatGPT Work et Codex pour les abonnés Plus, Pro, Business, Enterprise et Edu. Les utilisateurs Free et Go accèdent à Luna dans l’application de bureau. Aucun des deux n’est encore proposé dans l’interface de conversation classique (Chat).
Au passage, signalons que Sonnet 5.5 et Haiku 5.5 sont déjà annoncés pour les semaines à venir, que GPT-6 Terra ne devrait pas tarder, et que SpaceXAI semble bien décidée à livrer un nouveau Grok toutes les cinq à six semaines. Quant au « ralentissement » promis par les uns et les autres, il n’a, lui, toujours aucune date.
À LIRE AUSSI :
À LIRE AUSSI :
À LIRE AUSSI :
À LIRE AUSSI :