
Data / IA
Anticiper l’explosion des coûts de l’IA : Le Replay de la Matinale
Par Laurent Delattre, publié le 25 septembre 2026
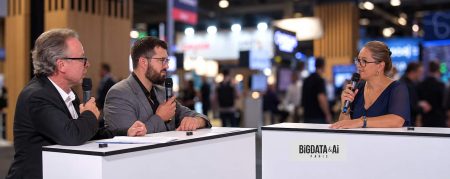
À force de parler du prix du token, on finirait presque par oublier ce qui fait vraiment exploser les dépenses en IA : les usages. Réunis le 17 septembre par Thomas Pagbé pour la Matinale IT for Business « Comment anticiper la future explosion du coût de l’IA ? », DSI, experts et fournisseurs dressent le même constat : l’agentique change l’échelle du problème, mais le véritable antidote n’est pas de compter frénétiquement les jetons. Il faut savoir pourquoi on les dépense, avec quel modèle, sur quelle infrastructure et surtout pour quelle valeur.
Le décor est planté d’entrée : selon McKinsey, 93 % des entreprises ont dépassé leur budget IA, et le passage à l’échelle multiplie la dépense par près de quatre. En cause, des agents autonomes et gloutons qui enchaînent les appels au modèle. Gartner a même trouvé un nom au phénomène : le « paradoxe de l’inférence ».
Jean-Christophe Heymonet, DSI d’Harmonie Mutuelle, donne ainsi le ton dès la keynote. Après la phase d’émerveillement, puis celle de l’angoisse de ne pas utiliser l’IA, la question du prix remet curieusement un peu de raison dans la pièce.
« Le “combien ça coûte ?” est plutôt salutaire. Le “ce n’est pas magique ?”, le “à quoi ça sert ?” reviennent sur le devant de la scène. (…) Il faut rester sur les grands pans de valeur. J’ai un collègue qui dit que même si ça coûtait dix fois plus cher, ça devrait continuer à rapporter de l’argent. (…) Raccrochons-nous à la valeur, et ensuite on verra. »
C’est aussi la ligne d’Ilham Guggenheim, directrice de programme SCA Plateforme au Service du commissariat des armées. Quand le débat glisse vers l’outillage nécessaire pour contrôler l’IA, elle inverse volontiers l’ordre des opérations :
« Je n’analyse pas les outils en premier : je pars du besoin, d’un cas d’usage, et l’IA n’y répondra peut-être pas au final. Parfois, on peut y répondre par de l’urbanisation, par du RPA, par un formulaire dynamique. (…) On a beaucoup oublié les leçons des ruptures précédentes. Quel est mon besoin ? Où est-ce que ça gratte ? La technologie est un moyen parmi tant d’autres d’y répondre. »
L’agent ne coûte pas cher. Il travaille tout le temps
Le sujet se corse évidemment avec les agents IA. Abdelbari Bouzarkouna, Data & AI Leader chez SoftwareOne, résume le piège :
« Le vrai risque n’est pas forcément l’explosion du prix de l’IA, mais l’explosion de son usage. Aujourd’hui, l’IA a un usage dynamique : elle fonctionne 24 heures sur 24, avec plusieurs utilisateurs, plusieurs agents qui collaborent et des appels à d’autres outils. (…) Au final, je ne paie pas une requête, je paie toute une chaîne d’actions. »
Autrement dit, comparer un chatbot et un workflow agentique au seul nombre de tokens n’a pas beaucoup de sens. Olivier Serfaty, directeur Data, IA et Innovation chez Inetum, pousse le raisonnement jusqu’au bout et démonte les multiplicateurs spectaculaires parfois annoncés :
« Lorsqu’on parle de x100, on compare le coût d’un workflow agentique à un simple appel à un chatbot. (…) Il faut comparer ce workflow à l’alternative humaine. Si ça nous prend trois jours pour obtenir cette information et qu’on le fait en trois heures, c’est ça qu’il faut comparer. Donc, multiplier par cinq le coût des tokens, probablement. Mais si c’est cinq, dix ou vingt fois moins cher que de le faire faire par des humains, peut-être que ça reste intéressant de payer plus cher. »
Le LLM ne pèse plus que 3 à 4 % de l’édifice. D’où l’essor du routage, qui choisit le modèle suffisant plutôt que le dernier cri, à l’image de Bob, l’assistant de code d’IBM, ou de watsonx Orchestrate, facturé à la mission plutôt qu’au token. Un rappel utile alors que l’industrialisation commence à donner des ordres de grandeur vertigineux.
IT for Business racontait ainsi quelques jours plus tard comment AT&T en est arrivé à 45 milliards de tokens par jour pour quelque 1 000 workflows agentiques. À lire pour prendre la mesure du changement d’échelle : Les 1000 workflows agentiques d’AT&T consomment 45 milliards de tokens par jour.
Arrêter de sortir la Ferrari pour aller chercher le pain
Une fois le bon cas d’usage trouvé, reste à éviter le réflexe le plus coûteux : envoyer chaque requête au modèle le plus puissant du moment.
Vincent Lavergne, Global AI Leader chez F5, insiste sur l’importance du routage, des quotas et du cache. Il plaide pour des indicateurs de « tokenomics » et des contrôles dignes d’une application critique :
« Ces agents peuvent se perdre dans leur propre réflexion et consommer énormément de tokens. On voit apparaître un nouveau type de solution, la passerelle IA, qui contrôle les quotas et met en place des mécanismes d’optimisation. Exemple tout bête : si tous les matins l’ensemble des employés demandent la météo pour savoir comment s’habiller, ça a un coût. Peut-être que je peux mettre cette réponse en cache pour éviter que 1 000 ou 2 000 employés fassent la même requête. »
Un cache « sémantique », précise-t-il, puisque la même question peut se formuler de mille façons. Autant d’économies pour la facture… et pour la planète.
Même logique chez Thomas Lussiez, Alliance Manager AWS chez Inetum : les plateformes multimodèles doivent permettre de sélectionner le modèle en fonction de la tâche, du niveau de performance attendu et du prix.
Stéphane Beaumont, directeur des ventes partenaires Europe du Sud chez Zoom, défend de son côté l’approche plateforme : IA native sans surcoût, crédits ZoomMate mutualisés et pilotés par les administrateurs, routage dynamique entre modèles via le Z-scorer, « le chef d’orchestre qui fait jouer la bonne partition avec le bon instrument ».
Les modèles économiques diffèrent, mais la logique reste finalement la même : le modèle n’est plus un choix par défaut, mais une ressource que l’on doit aiguiller selon la tâche.
Sur ce sujet, notre article « Hausse des usages… mais le prix moyen des tokens se stabilise » montre justement comment le routage entre modèles économiques, modèles ouverts et modèles premium devient une véritable discipline de production.
Piloter. Avec du FinOps… métier !
Le coût brut reste pourtant un indicateur assez pauvre. Comme Olivier Serfaty le souligne, savoir qu’une entreprise a consommé dix millions de tokens ne dit pas ce qu’elle a acheté avec. Son approche consiste donc à remonter du coût technique vers l’acte métier : combien coûte l’analyse d’un CV, d’un contrat, la production d’un tableau financier ? Ensuite seulement viennent l’optimisation du prompt, le choix du modèle, le cache et la simplification du workflow.
Mélissa Koçan, AI Business Partner à la Matmut, se tient « à l’intersection » des métiers, de la technologie et de la gouvernance. Chez l’assureur, tout commence très tôt :
« La supervision commence avant même la consommation du premier token. On va qualifier chaque usage : quel est le besoin, quel est le bénéfice client attendu, quel est le bénéfice métier attendu ? Il faut des réponses à ces deux questions avant de lancer un projet. J’en rajouterais même deux autres : combien est-ce que ça nous coûte, et est-ce qu’on n’aurait pas une solution plus sobre à mettre à disposition ? »
Chez Christofle, Haifa Dalaji, DSI, raconte une expérimentation très concrète : un assistant shopping testé sur environ 500 conversations a produit un taux de conversion proche de 6 %. Mais elle refuse d’en faire trop vite un trophée IA :
« Nous ne sommes pas en mesure de dire que toutes ces conversions ont été obtenues grâce aux conversations avec l’agent. Il faut distinguer ce qu’on observe de l’IA de ce qu’on peut réellement lui attribuer comme bénéfice. »
On touche là l’un des garde-fous financiers les plus simples à retenir de cette matinée : ne pas confondre corrélation, usage et ROI. Reste à mesurer le bon périmètre. Comme nous le rappelions cet été dans notre enquête sur le vrai coût de l’IA dans les budgets IT, la facture de tokens n’est que la partie émergée : infrastructure, supervision des agents, résilience et sécurité composent un TCO bien plus large.
16 000 dollars par développeur et par mois
Et quand la facture de tokens s’emballe, c’est souvent là où on l’attendait le moins : sur le poste du développeur. Eric Bezille, CTO Ambassador chez Dell Technologies, a sorti les chiffres qui piquent. Selon Gartner, un quart des entreprises sondées dépensaient déjà 200 à 500 dollars par mois et par développeur en assistants IA, une facture qui pourrait égaler en 2028 le salaire moyen d’un développeur. Sauf que 2028, c’est maintenant :
« Autour de juin, j’ai commencé à avoir des appels entrants. Des clients avaient fait x8 sur leur coût de consommation de ces assistants. D’autres avaient un coût moyen par poste autour de 1 000 dollars, qui pouvait monter à 16 000 dollars par mois et par développeur. On commence déjà à matérialiser en 2026 la prédiction de Gartner pour 2028. (…) La problématique, c’est qu’ils ne peuvent pas s’en passer. »
Sa réponse : l’AI Factory, socle intégré de la donnée aux garde-fous, et surtout l’hybridation, du poste de travail (quelques milliers d’euros, amortis en trois mois environ) au cloud public, pour exécuter « le bon modèle, au bon endroit, au bon moment et sur la bonne donnée ». Une fois l’infrastructure maîtrisée, « ce n’est plus un sujet de coût du token, c’est un sujet d’optimisation », à condition de réévaluer sa stratégie tous les 18 mois.
Une stratégie que nous détaillions dans nos 10 annonces à retenir de Dell Technologies World 2026.
Souveraineté, on-premise et hybridation
Ne plus pouvoir s’en passer, c’est précisément le risque : qui dépend de l’IA dépend aussi de celui qui la fournit.
Première parade, la plus radicale : faire soi-même. C’est la voie décrite par Ilham Guggenheim : une IA générative développée en interne au ministère des Armées, avec plusieurs modèles et des usages RAG adaptés aux corpus des différentes entités.
« Le ministère des Armées a adopté une méthode frugale et de bon sens : développer sa propre IA et en maîtriser les usages. Nous l’avons développée grâce au centre d’expertise IA et Data du secrétariat général pour l’administration, et nous avons aujourd’hui plus de 100 000 utilisateurs. C’est un vrai succès pour une solution maison. »
Pas question de courir après la nouveauté. On cherche le modèle qui suffit au besoin, dans un cadre de gouvernance maîtrisé :
« Notre ambition n’est pas d’utiliser le dernier cri, mais le modèle le plus adapté à nos besoins. Avec le RAG, l’IA n’interroge plus le modèle général, elle interroge nos documents. Cela exige une vraie rigueur dans la gestion de l’information : une bibliothèque propre, régulièrement mise à jour et au service de son objectif. »
Forte de vingt ans passés dans le privé, elle tranche aussi la question de la rentabilité :
« Au regard de ce que j’ai connu dans le privé, c’est clairement plus rentable. Nos métiers sont si spécifiques que les solutions du marché demanderaient beaucoup de temps et d’énergie pour être adaptées, puis adoptées. »
Deuxième parade : ne jamais s’enfermer. Pour Jean-Christophe Heymonet, un partenariat sans porte de sortie reste une dépendance :
« Dans partenariat, il y a partenaire. Or, aujourd’hui, les grands fournisseurs d’IA ne sont pas des partenaires : ce sont des fournisseurs de solutions. S’enfermer dans une solution sans aucune porte de sortie n’a rien de positif pour les trois ou quatre ans à venir. Je ne dis pas qu’il ne faut pas nouer de partenariats, mais il faut le faire avec raison gardée. »
L’open source, le recours à plusieurs modèles et les compétences internes deviennent ainsi des leviers de maîtrise économique :
« Depuis plus de dix ans, notre stratégie repose sur l’open source : nous approprier la technologie, la maîtriser, et ne recourir aux fournisseurs que lorsqu’ils apportent du spécifique. Toute la question est de savoir si l’on maîtrise son destin, ou si l’on dépend de la décision d’un partenaire qui voudra augmenter ses tarifs de 10, 20, 30 ou 40 %. Cette dépendance a-t-elle de la valeur, ou ma valeur est-elle dans l’indépendance ? »
Troisième parade, enfin : l’hybridation. Eric Bezille (Dell Technologies) en fait la condition architecturale de cette indépendance :
« Il ne s’agit pas de choisir l’un ou l’autre, mais d’exécuter le bon modèle, au bon endroit, sur la bonne donnée, avec la bonne performance, la bonne souveraineté et au bon coût. Les entreprises savent qu’elles ne peuvent plus se passer de l’IA. Pour garder le contrôle de leur destinée, elles doivent se doter de ces capacités d’hybridation et maîtriser l’équation économique qui va avec. »
Compter juste, consommer sobre
La facture va-t-elle exploser ? Très probablement si les usages, eux, explosent. Et tout porte à croire qu’ils vont effectivement exploser.
Raison de plus pour ne pas se tromper d’instrument : le token est une simple unité de consommation… certainement pas une boussole.
Le vrai sujet est de savoir combien de tâches l’entreprise automatise, avec quelle qualité, quels contrôles, quelle dépendance, quelle empreinte et quelle valeur en face.
La sobriété finit d’ailleurs par réconcilier très directement maîtrise budgétaire et Green IT. Pour Mélissa Koçan, l’écoconception appliquée à l’IA consiste d’abord à « choisir un modèle sobre, éviter une surconsommation ou un choix de surpuissance sur un cas d’usage qui serait simple », mais aussi à « éviter les usages superflus ». Avec un bénéfice presque mécanique : « ça réduit potentiellement l’empreinte, mais aussi la facture ».
Jean-Christophe Heymonet allait encore un cran plus loin en ouverture de l’émission en rappelant que le coût de l’IA ne se mesure pas qu’en euros : « un jeton, c’est aussi un indicateur de CO2 ». Et de résumer l’équation désormais posée aux DSI : « Est-ce que ce que je fais a une valeur économique, et combien ça pollue ? »
Mesurer, arbitrer, garder les compétences en interne et ne jamais perdre de vue ce que l’IA rapporte : voilà le vrai plan d’économies.
À LIRE AUSSI :