Newtech
Vincent Franceschini (Biomemory) : « Une fois dans l’ADN, l’information numérique ne peut plus être modifiée »
Par Laurent Delattre, publié le 13 novembre 2026
Longtemps, le stockage de données dans l’ADN a ressemblé à une curiosité de laboratoire. La start-up française Biomemory veut désormais en faire une technologie utilisable par les entreprises. Fondée en 2021, née de travaux menés au CNRS et à la Sorbonne, elle mise sur une approche originale : traduire des fichiers numériques en séquences d’ADN synthétique, puis assembler ces séquences bloc par bloc grâce à des enzymes. Une sorte d’impression moléculaire, en somme, avec à la clé une densité de stockage théorique vertigineuse et une conservation qui pourrait se compter en décennies, voire en siècles, plutôt qu’en années.
Depuis le rachat des actifs de l’américain Catalog Technologies en mars 2026, Biomemory dispose d’un pied à Paris et d’un autre à Boston. Et elle commence à transformer sa recherche fondamentale en offre commerciale. Lancé en octobre, DNA Shield est un service de protection de données critiques : clés cryptographiques, secrets industriels, preuves d’intégrité ou documents patrimoniaux sont convertis en ADN, placés hors ligne et conservés dans des supports physiques scellés. Certes, la solution n’est pas encore une alternative aux bibliothèques de bandes et aux baies de stockage. Mais DNA Shield joue une autre carte, celle du coffre-fort durable, pour les informations que l’on ne peut vraiment pas se permettre de perdre… ni de voir altérées.
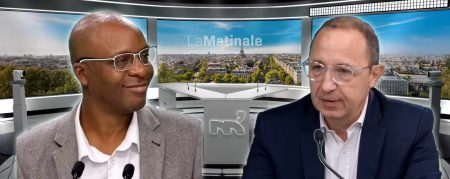
Vincent Franceschini, vice-président chargé des produits chez Biomemory et coprésident de la DNA Data Storage Alliance, nous explique le fonctionnement de cette nouvelle technologie, ses limites très concrètes, ses premiers débouchés et les ambitions de l’informatique moléculaire. Avec une promesse spectaculaire, mais aussi de sérieux défis d’industrialisation.
IT for Business — Pourquoi un DSI devrait-il s’intéresser aujourd’hui au stockage sur ADN ?
Vincent Franceschini — L’informatique a toujours évolué en intégrant de nouvelles technologies : l’optique, de nouvelles architectures de processeurs, de nouveaux réseaux… Nous pensons que l’informatique moléculaire suivra cette trajectoire. Et son premier jalon, c’est le stockage.
L’ADN possède des qualités remarquables. Une densité, d’abord : il est entre un million et un milliard de fois plus dense que n’importe quel média existant. Une très grande stabilité dans le temps, ensuite, et la possibilité de conserver les données complètement déconnectées des réseaux. Et surtout l’immuabilité : une fois l’information inscrite dans l’ADN, on ne peut plus y toucher, elle n’est plus modifiable.
L’enjeu, pour les DSI, est aussi de s’affranchir des migrations de données imposées par le vieillissement des supports. Aujourd’hui, quand on conserve des informations pendant plusieurs décennies sur des bandes ou des disques, on doit tous les cinq, dix, quinze ou vingt ans changer de génération technologique, recopier les données, contrôler les opérations. Ces migrations sont coûteuses et risquées. Le format de l’ADN, lui, ne sera jamais obsolète. Encore faut-il garantir qu’on saura relire ce qu’on a écrit : toute la difficulté est de contrôler la qualité de l’écriture.
DNA Shield, c’est donc davantage un coffre-fort qu’une solution de stockage classique ?
Pour commencer, oui. Nous démarrons par là, parce que les capacités de production actuelles ne permettent pas encore de rivaliser avec le stockage traditionnel en volume. Nous ne remplaçons pas la chaîne de cybersécurité : nous en sommes un maillon, qui vient s’y greffer pour renforcer la protection des données. DNA Shield vise des informations de taille raisonnable, mais extrêmement précieuses : propriété intellectuelle, formules industrielles, algorithmes, secrets d’entreprise, documents réglementaires ou éléments permettant de vérifier l’intégrité de données conservées ailleurs.
Il y a aussi une dimension réglementaire et de souveraineté. Une réglementation peut vous imposer de restituer des données dans vingt-cinq ou quarante ans, en garantissant leur intégrité. Les signatures et les preuves d’intégrité embarquées dans l’ADN permettront de la démontrer, puisque ce qui y a été inscrit ne pourra jamais bouger.
Concrètement, quel scénario de cyberattaque justifierait de passer par l’ADN ?
Prenons les HSM, ces modules matériels qui protègent les clés cryptographiques. Ils se sauvegardent les uns les autres. Mais que se passe-t-il si l’ensemble des HSM est compromis ? Tout tombe. Il faut alors aller chercher ses données de référence hors de ce périmètre. Je vais les chercher dans l’ADN, parce que je sais que personne n’aura pu y toucher.
Autre scénario : le ransomware. Après une attaque, vous restaurez des sauvegardes, mais comment être certain que les sauvegardes elles-mêmes n’ont pas été altérées ? Vous pouvez conserver dans l’ADN des preuves d’intégrité qui serviront de référence lors de la reprise. L’ADN n’ayant pu être ni atteint ni attaqué, cette preuve reste disponible à tout moment. Nous avons d’ailleurs commencé à travailler avec des acteurs des HSM et, plus largement, de la cybersécurité, même s’il est trop tôt pour détailler ces collaborations.
Comment transforme-t-on concrètement un fichier informatique en ADN ?
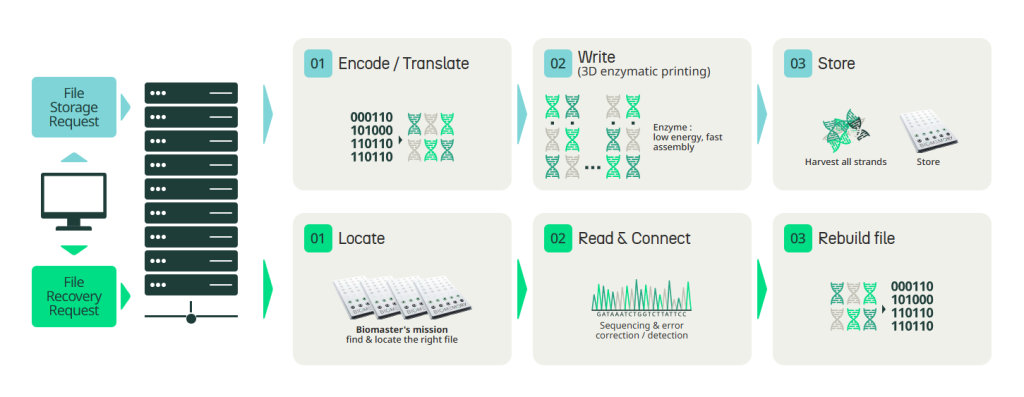
Dans le stockage classique, vous achetez un récipient, puis vous le remplissez de données. Avec l’ADN, nous fabriquons le support en même temps que nous y inscrivons l’information. Nous partons du fichier binaire, peu importe qu’il s’agisse d’un PDF, d’une image ou d’un autre format. Notre codec le traduit en une séquence quaternaire, qui sera assemblée à partir de blocs d’ADN prédéfinis. Nous utilisons seize blocs, chacun représentant un demi-octet.
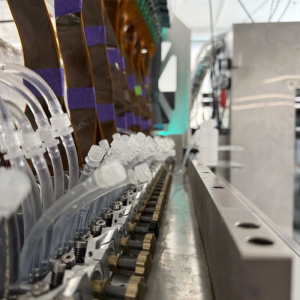
La séquence est ensuite transmise à notre « bio-writer », un équipement d’impression enzymatique 3D. Des encres biologiques apportent les blocs d’ADN, et des enzymes jouent le rôle de colle pour les assembler. Une fois synthétisé, l’ADN est déshydraté puis placé dans une capsule scellée – en métal et soudée au laser pour les versions initiales -, logée dans une DNA Card, un support de la taille d’une à deux cartes de crédit. Pour relire les données, on suit une autre chaîne technologique : le séquençage de l’ADN, puis le décodage et la reconstruction du fichier.
Capacité, écriture, lecture : quels sont les chiffres aujourd’hui ?
Aujourd’hui, une requête d’écriture porte sur plusieurs dizaines de mégaoctets utilisateurs. Nous passerons très vite aux centaines de mégaoctets, puis au gigaoctet. La densité physique de l’ADN laisse entrevoir des capacités bien plus élevées : dans nos capsules, je pourrais mettre ce que je veux. La densité de l’ADN n’est pas le véritable défi : c’est dans la production d’ADN, autrement dit la synthèse, que se jouent les enjeux d’aujourd’hui.
Hormis les délais de traitement liés aux requêtes de données, l’écriture s’effectue dans les 24 heures et la lecture en quelques heures, en fonction du volume des données. Il ne faut d’ailleurs pas confondre ce qui sera disponible au travers de la plateforme DNA Shield et ce qui est possible technologiquement d’atteindre en lecture ou en écriture. Nous comptons sur notre programme d’accès anticipé pour optimiser ces cycles. Enfin, la qualité de l’écriture est contrôlée par des stratégies de relecture, pour s’assurer que l’ADN produit garantit la pérennité, l’accessibilité et l’intégrité de la donnée sur la durée visée.
Vous annoncez jusqu’à 150 ans de conservation. Comment le prouver ?
Nous avons conçu nos supports pour atteindre cette durée, et nous travaillons à la forme que prendra l’engagement commercial associé : une garantie d’accessibilité du média et d’intégrité de la donnée. Les constructeurs de stockage traditionnels, eux, ne garantissent pas leurs médias sur de telles durées ; ils recommandent des conditions de préservation. Scientifiquement, il existe des méthodes de vieillissement accéléré, jouant notamment sur la température, qui permettent d’évaluer la stabilité et la lisibilité de l’ADN dans le temps. Notre objectif est de permettre le stockage dans une large plage de températures, comprise entre 5 et 35 °C, sans infrastructure de conservation spécifique que ce soit dans un datacenter ou pas.
Il ne faut cependant pas imaginer que chaque molécule restera intacte pendant 150 ans. L’ADN peut se dégrader ; la redondance permet de préserver l’information. Les brins sont produits par centaines de milliers, et nous ajoutons des codes correcteurs d’erreurs à tous les étages de la chaîne, dès le codec. Au lancement, nous visons un taux d’erreur binaire non récupérable de l’ordre de 10−16, avec l’ambition de rejoindre puis de dépasser les standards du marché, entre 10−17 et 10−19.
Qui détient les DNA Cards et où sont-elles produites ?
Chaque écriture donne lieu à au moins trois supports physiques : deux sont destinés à la redondance, et un troisième sert prioritairement aux demandes de relecture, pour éviter de solliciter les exemplaires de protection. Ensuite, plusieurs organisations sont possibles. Le client peut récupérer toutes ses cartes sur ses propres sites, voire les répartir entre plusieurs pays. Il peut aussi confier tout ou partie des exemplaires, la carte de lecture par exemple, à un partenaire spécialisé dans le gardiennage sécurisé. Ce partenaire n’est jamais Biomemory elle-même : il est installé à proximité du site de relecture.
Côté production, nous disposons de capacités aux États-Unis, et un site sera opérationnel en France en 2027.
Comment DNA Shield s’intégrera-t-il au système d’information ?
Au départ, par un service en ligne, en mode SaaS. Pour les premiers pilotes, le client dépose sur une plateforme sécurisée des fichiers chiffrés, ce qui sera un prérequis. Nous les convertissons en ADN, puis les supports sont remis ou conservés selon le dispositif choisi. Une fois l’information transférée dans l’ADN, nous ne conservons aucune trace du fichier binaire d’origine sur nos plateformes.
Très rapidement, nous proposerons une intégration par API S3, devenue un standard de fait bien au-delà d’AWS, y compris dans les solutions de stockage sur site. Car derrière, il y a l’automatisation du « data tiering », le déplacement des données entre les différentes couches de stockage. Notre partenariat annoncé en juin avec Scality s’inscrit dans cette logique.
Et si Biomemory disparaît dans quarante ans ? Comment relire les cartes ?
Nous y avons pensé dès le début. Sur le plan contractuel, les informations nécessaires à la lecture seront placées sous séquestre (« escrow »), afin que le client puisse les récupérer si Biomemory n’existe plus. Mais il faut aussi une réponse industrielle.
La DNA Data Storage Alliance, hébergée par la SNIA, travaille sur la standardisation des technologies de stockage ADN. Nous étudions notamment la possibilité d’embarquer dans le support des informations décrivant comment l’ADN a été créé et les ressources nécessaires pour le lire, sans compromettre la confidentialité. Une autre piste serait un service comparable au DNS : à partir du numéro de série d’une DNA Card, on retrouverait son origine, le codec employé, sa date de création et les informations techniques utiles pour y accéder. Ces travaux sont en cours. Et il y a un avantage de fond : tant qu’il y aura des humains sur Terre, il y aura des séquenceurs d’ADN.
L’ADN pourra-t-il un jour coûter moins cher que la bande magnétique ? Et consommer moins ?
Nous espérons qu’il sera moins cher. Au moins équivalent, j’y crois franchement. Aujourd’hui, les consommables, notamment les enzymes, restent chers. Mais nous envisageons sur ces matériaux de base des facteurs de réduction de 100 à 1 000, grâce à la montée en volume et à la maîtrise de notre propre chaîne de production. Nous voulons être leaders, mais nous souhaitons ne pas être les seuls : pour être pérenne et peser au niveau stratégique mondial, une industrie doit être portée par plusieurs acteurs.
Sur l’énergie, l’avantage est immédiat une fois les données stockées : le support ADN ne consomme aucun watt pour conserver l’information. Écriture et séquençage, bien sûr, demandent de l’énergie. Mais nous sommes à des fractions de la consommation des disques durs ou des bibliothèques de bandes en silo. On objectera que les bandes stockées hors site, déconnectées, ne consomment plus rien. Reste à les y acheminer, ce qui a aussi un coût énergétique. Des études de Microsoft montraient, il y a quelques années déjà, des réductions d’un facteur 100 environ sur l’eau, l’électricité et les émissions de gaz à effet de serre par rapport aux technologies existantes. Nous menons nos propres analyses de cycle de vie pour disposer de chiffres spécifiques à notre procédé, mais les ordres de grandeur sont là.
Où en sont les premiers clients et les projets pilotes ?
Nous avons déjà travaillé sur la maturation de la technologie avec des organisations comme le Ministère des Armées, le CNES ou SICPA. Avec DNA Shield, nous ouvrons une nouvelle phase : un programme d’accès anticipé, dont les projets pilotes doivent démarrer dès janvier 2027.
Nous ne communiquons pas encore les noms des participants, ni le tarif des pilotes : ce sera fait en accord avec eux. Pouvoir témoigner le plus rapidement possible fait d’ailleurs partie de nos motivations. Nous sommes aujourd’hui l’une des très rares plateformes disponibles pour tester concrètement le stockage de données dans l’ADN, et nos clients comme nos prospects nous disent qu’ils pensaient que cela n’arriverait pas avant des années.
Dans dix ans, Biomemory sera-t-elle un nouveau fournisseur de stockage ou quelque chose de différent ?
Si notre feuille de route se déroule comme prévu, nous aurons dépassé la notion d’archivage classique pour aller vers le stockage de masse des données froides, avec un ROI et un TCO proches de ceux des médias concurrents. Mais la vraie question est de savoir si les utilisateurs se projetteront ainsi.
Je pense qu’une segmentation naturelle va apparaître. Les bandes, les disques et les autres technologies resteront pertinents pour des archives que l’on doit régulièrement relire ou réinjecter dans des applications et des data lakes. L’ADN aura surtout sa place pour la préservation à très long terme des données que l’on lit rarement, voire jamais, sans migrations périodiques des supports. Certains clients me demandent déjà si nous envisageons du « tiering » de la bande vers l’ADN, piloté par les politiques de gestion du cycle de vie. J’y crois beaucoup, mais pas forcément en confrontation frontale avec les technologies existantes. Les utilisateurs décideront finalement de cette répartition.
Et notre ambition va au-delà de l’archivage. Nous travaillons, encore au stade de la R&D, à des fonctions de recherche et de calcul directement dans l’ADN : retrouver la bonne donnée dans des volumes massifs, ce vieux problème de l’aiguille dans la botte de foin ; chiffrer tout ou partie des données au niveau moléculaire ; et même exécuter des réseaux de neurones simples, comme des expériences l’ont déjà démontré. Imaginez un DPU (Data Processing Unit) intégré directement à un disque dur ou à un SSD : une capacité de traitement embarquée au plus près du support et de la donnée. Le stockage n’est que le premier jalon de l’informatique moléculaire.
À LIRE AUSSI :
À LIRE AUSSI :