Data / IA
Chez Revolut, l’IA réinternalisée coûte dix fois moins cher que Claude
Par Reynald Fléchaux, publié le 05 novembre 2026
En remplaçant une IA propriétaire par un modèle ouvert exécuté sur ses propres GPU, Revolut affirme avoir divisé par dix ses dépenses d’inférence pour ses développeurs. Une baisse des coûts qui débouche sur une croissance des usages de l’IA mais soulève aussi des questions sur la capacité des fournisseurs de modèles à rentabiliser leurs investissements.
Pour réduire sa facture d’IA, Revolut a choisi de réinternaliser l’inférence. Après avoir expérimenté Gemini, puis largement adopté Claude Code et les services d’OpenAI, la fintech britannique a fait d’un modèle à poids ouverts son outil de développement par défaut. Résultat revendiqué : une division par dix du coût des tokens, ces unités de traitement facturées par les fournisseurs d’IA. Une décision qui remet en lumière un arbitrage familier des DSI : à partir de quel volume devient-il plus intéressant d’exploiter ses propres infrastructures plutôt que de payer un service à la consommation ?
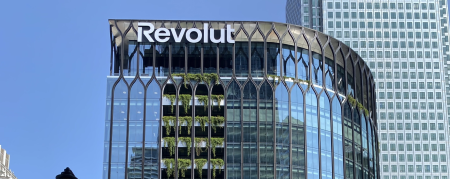
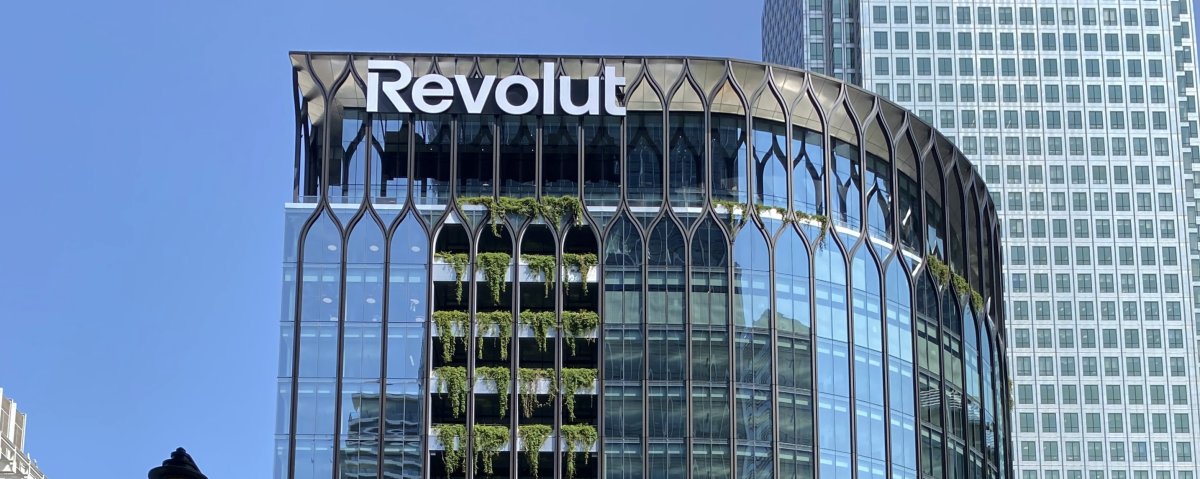
Chez Revolut (en photo, le siège de la banque à Londres), la question s’est posée avec la généralisation de l’IA auprès des quelque 2 000 ingénieurs. « Nous voyions des ingénieurs dépenser 1 000, voire 10 000 dollars par mois, sans grand retour sur investissement », a expliqué David Abitbol, responsable des opérations et des infrastructures, lors de la conférence AI Engineer, organisée à New York en octobre. Face à ces dépenses difficilement prévisibles, Revolut avait imposé des plafonds stricts de consommation. Mais cette mesure budgétaire limitait aussi l’utilisation de la technologie.
La fintech a finalement opté pour la réinternalisation, avec des modèles GLM, une famille développée par le chinois Z.ai. Après une première adoption de GLM-5.1, Revolut fait aujourd’hui tourner GLM-5.3 sur un parc de 56 GPU Nvidia B200. L’entreprise annonce un coût moyen de 0,30 $ par million de tokens, entrées et sorties confondues, soit environ un dixième de la dépense antérieure auprès d’Anthropic et OpenAI.
Le retour du calcul économique de l’internalisation
En contrepartie, l’entreprise supporte le coût de ses GPU et de leur fonctionnement, mais peut répartir cette dépense sur un volume élevé de requêtes, sans payer chaque token au tarif d’une API commerciale. La performance économique repose aussi sur l’optimisation de l’inférence, confiée aux équipes internes. Celles-ci ont notamment travaillé sur la quantification du modèle, la séparation des phases de traitement et la taille des fenêtres de contexte. À nombre de GPU constant, Revolut indique avoir augmenté de 76 % le nombre de requêtes traitées par seconde et réduit de 88 % le délai avant l’apparition du premier token (TTFT), passé de 14,26 à 1,68 seconde.
Ces résultats supposent évidemment une consommation suffisante pour amortir le matériel, ainsi que des compétences pour exploiter et optimiser les modèles. De plus, Revolut ne publie pas de décomposition précisant le périmètre auquel se rapportent les 0,30 $ par million de tokens.
Revolut libère l’IA au-delà du code
Quelle que soit son ampleur exacte, cette baisse des coûts a eu un effet important sur les usages : la levée des restrictions qui encadraient le travail des développeurs. Ces derniers ne sont plus contraints de réserver leurs tokens aux tâches jugées prioritaires. Les ingénieurs peuvent désormais solliciter l’IA pour déboguer leurs applications, rechercher des informations dans la documentation interne ou traiter des tickets Jira et des contenus Confluence. Autant d’activités périphériques à l’écriture du code, mais qui pèsent lourdement sur les délais de livraison.
Sur la base des usages de ses quelque 2 000 ingénieurs, la fintech revendique une amélioration de 60 % du temps consacré au codage et de 70 % du délai entre la prise en charge d’une fonctionnalité et sa préparation au déploiement, par rapport aux niveaux précédant tout déploiement de technologies de GenAI. Pour David Abitbol, accélérer la production de code ne suffit pas si les autres étapes du développement restent inchangées. En rendant l’inférence beaucoup moins coûteuse, Revolut a pu étendre l’automatisation à ces tâches parfois jugées périphériques.
La banque ne s’est cependant pas enfermée dans un modèle unique. GLM reste privilégié pour les traitements textuels et le développement, tandis qu’un routeur dirige certaines requêtes, notamment celles nécessitant des capacités visuelles, vers des modèles propriétaires de Google ou d’OpenAI. L’auto-hébergement devient ainsi le socle des usages courants, les services externes faisant office de complément.
Les banques internalisent leur IA, les fournisseurs sous pression
Si elles n’ont pas évoqué à ce stade un modèle hybride de ce type, plusieurs autres banques européennes entendent bien, elles aussi, garder la main sur leur inférence, pour des raisons d’indépendance, de confidentialité des données, mais aussi de maîtrise des coûts. BNP Paribas exploite ainsi déjà une plateforme interne de GenAI, alimentée par ses propres GPU. Cette plateforme traite environ 1,5 milliard de tokens par jour et la banque estime son coût total inférieur à celui du cloud, sans toutefois publier de chiffre précis. Crédit Agricole prévoit de son côté 100 à 200 M€ d’investissements dans deux nouvelles salles informatiques destinées notamment à l’inférence. Une décision qui répond explicitement à une préoccupation économique, son directeur général, Olivier Gavalda, mentionnant le risque de voir les gains de productivité de l’IA absorbés par ses fournisseurs.
Ce mouvement d’internalisation interroge les investissements colossaux de l’industrie de l’IA. Surtout avec des modèles open weight dont les performances deviennent suffisantes pour certains usages professionnels. À l’image de Revolut, les entreprises pourraient réserver les modèles propriétaires aux traitements pour lesquels leur supériorité technologique justifie un surcoût, et exécuter en interne le tout-venant des requêtes. Un virage qui pourrait accentuer la pression des marchés financiers sur les grands acteurs de l’IA, contraints de rentabiliser des modèles toujours plus coûteux tout en voyant une partie des volumes d’inférence les plus rentables leur échapper.
Photo : Boubloub/CC0 1.0
À LIRE AUSSI :
À LIRE AUSSI :
À LIRE AUSSI :
À LIRE AUSSI :