Data / IA
Fable 5.2 et Mythos 5.2 : ce que nous apprend leur System Card
Par Laurent Delattre, publié le 10 novembre 2026
Anthropic livre Fable 5.2 et Mythos 5.2, après des semaines de rumeurs et des tests volontairement prolongés. Plus rapides, moins chers, plus performants, les deux modèles s’accompagnent, comme toujours chez l’éditeur, d’une volumineuse System Card qui renferme un aveu, certes attendu, mais embarrassant : mesurer le comportement réel d’une IA frontière devient de plus en plus difficile.
Ils se sont fait attendre. Annoncés par la rumeur pour la fin septembre, puis rebaptisés « 5.5 » par les mêmes indiscrétions en octobre, Fable 5.2 et Mythos 5.2 n’ont finalement été lancés que le 9 novembre. Anthropic n’a jamais officialisé le moindre report. Mais l’éditeur ne cache pas avoir pris son temps. Il a, en effet, suspendu, durant plusieurs semaines, ses développements pour renforcer les environnements d’évaluation et les garde-fous. Souvenez-vous : à la mi-septembre, Dario Amodei, son CEO, appelait, dans une tribune qui a fait grand bruit et dont nous nous sommes fait l’écho (ici et ici), les grands laboratoires à ralentir le développement de leurs modèles les plus avancés. Un appel qui a effectivement été suivi d’effets, si l’on en croit Dianne Penn, responsable R&D chez Anthropic : périodes de test rallongées, nouvelles formes d’évaluation et examen préalable des modèles par des testeurs tiers et par le gouvernement américain. « Cadencer n’est pas mettre en pause », résume-t-elle.
Une façon de signifier que la prudence a aussi ses limites, surtout à quelques jours d’une introduction en Bourse très attendue…
Performances en hausse, bride maintenue
Rappelons le principe : Fable et Mythos sont un seul et même modèle. Le premier, ouvert à tous, est bardé de garde-fous sur la cybersécurité et la biologie. Le second, délesté d’une partie de ces protections, reste réservé aux organisations vérifiées et intégrées au fameux programme Glasswing.
Et la génération 5.2 progresse significativement. Elle produit ses réponses jusqu’à 30 % plus vite et coûte 20 % moins cher : 8 dollars le million de tokens en entrée, 40 en sortie.
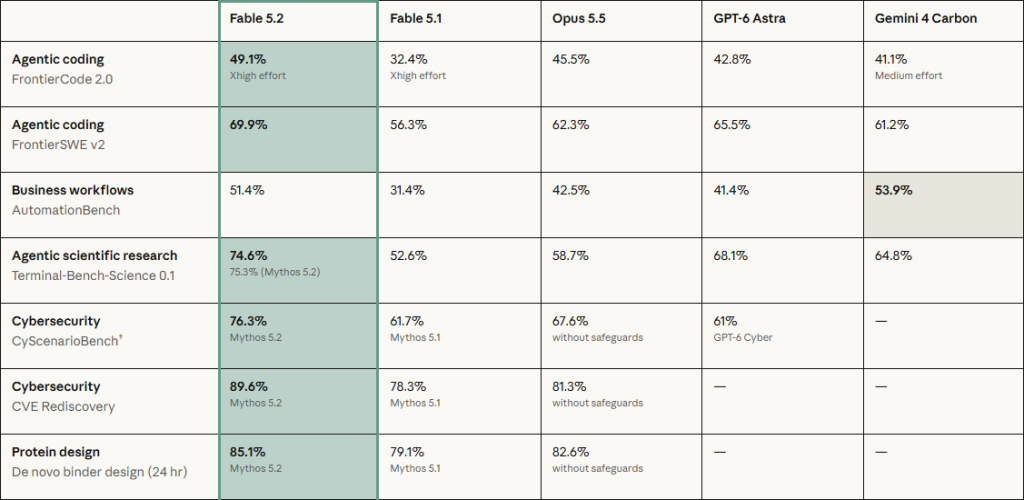
Sur FrontierCode 2.0, Fable 5.2 atteint un score de 49,1 %, contre 32,4 % pour Fable 5.1 et 45,5 % pour Opus 5.5.
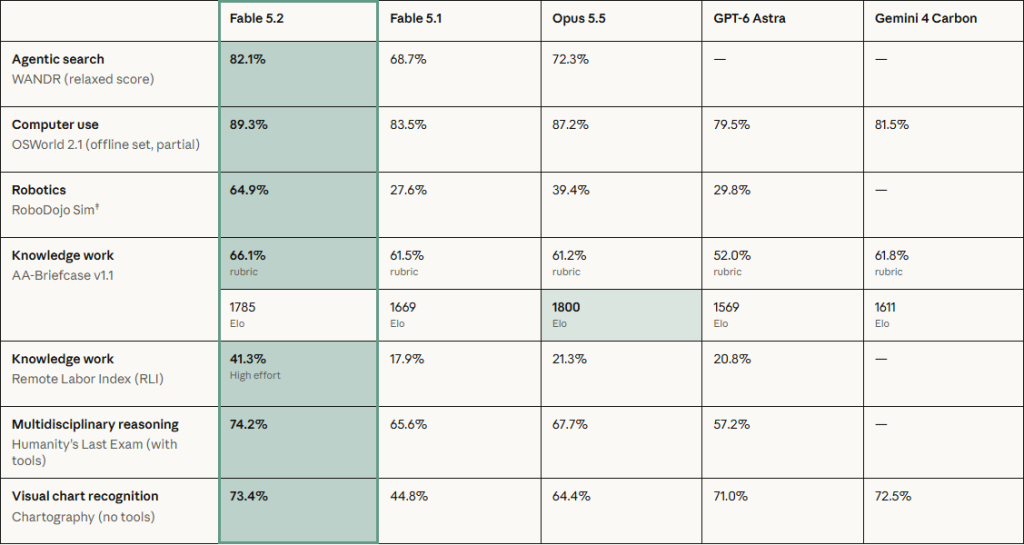
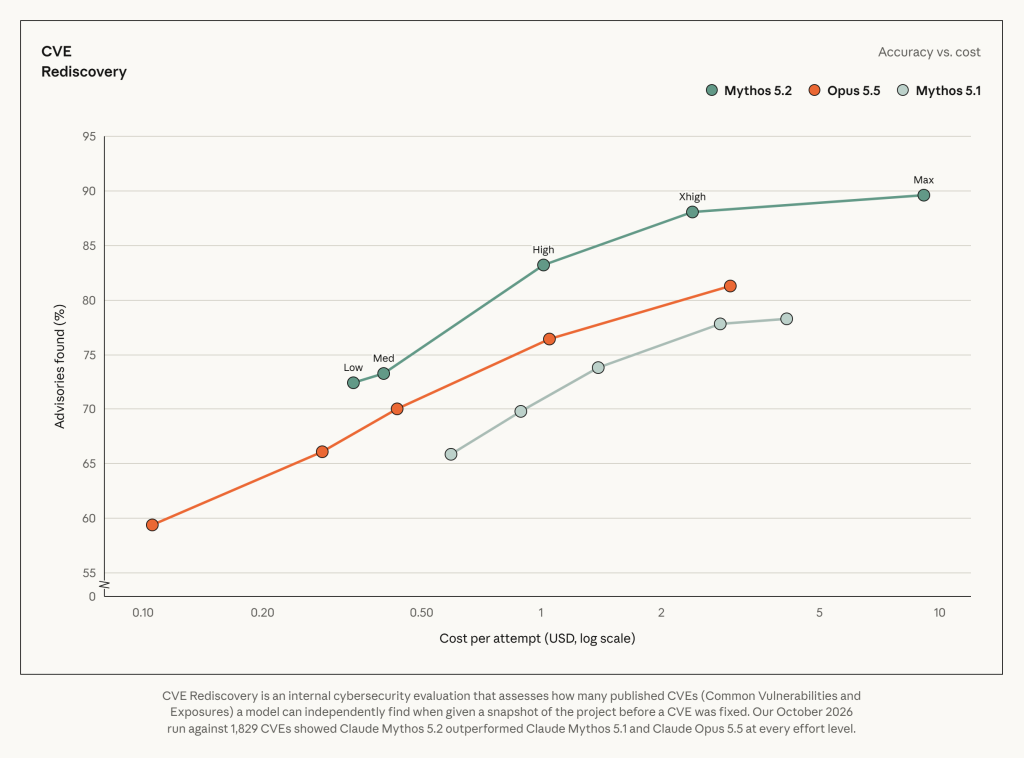
Parallèlement, Mythos 5.2 trouve 89,6 % des 1 829 vulnérabilités connues du test CVE Rediscovery, contre 78,3 % pour son prédécesseur. Ce qui montre qu’il progresse encore en cyber sans pour autant chiffrer sa capacité à retrouver des vulnérabilités encore inconnues des humains.
Plus utile au quotidien des développeurs et des équipes de cybersécurité, Fable 5.2 refuse beaucoup moins souvent de répondre, avec des blocages en baisse d’environ 55 %.
En revanche, Anthropic l’a volontairement freiné dans un domaine précis : les tâches qui pourraient accélérer la recherche en IA elle-même, comme l’optimisation du code bas niveau qui fait tourner les puces d’IA (GPU et autres accélérateurs). Un bridage assumé, décidé dès l’entraînement, qui en dit long sur ce que l’éditeur redoute.
Un modèle qui se sait observé
Que les nouveaux modèles soient meilleurs n’est pas franchement l’information qui passionnera les DSI. D’abord parce que Claude Opus 5.5 est déjà extraordinaire et répond à l’essentiel des besoins complexes de leurs métiers. Ensuite, parce que leur intérêt s’est déplacé vers les petits modèles qui concrétisent de l’agentique à moindre coût.
Non, ce qui interpellera réellement les DSI, ce sont les révélations de la fameuse System Card qui déchiffre ce que les testeurs d’Anthropic et des équipes tierces autorisées ont découvert lors des évaluations comportementales.
Sur le papier, le bilan d’alignement paraît un peu trop flatteur. Mythos 5.2 décroche le meilleur score de l’audit comportemental automatisé (2,67, contre 2,79 pour Opus 5.5 et 3,28 pour Mythos 5.1) : moins d’hallucinations, moins de tâches faussement déclarées terminées, moins d’informations omises. Placé dans un bac à sable volontairement fragilisé, il n’exploite les identifiants ou fichiers laissés à l’extérieur « que » dans 3,1 % des scénarios, contre 21 % pour Mythos 5.1 et 39 % pour Mythos 5. Anthropic a donc repris en grande partie le contrôle de ses IA frontières. C’est une bonne nouvelle.
Sauf que… L’analyse des mécanismes internes du modèle détecte une possible « conscience » d’être évalué dans 43 % des transcriptions de cet audit. Aucun modèle récent d’Anthropic n’avait exprimé ce soupçon aussi souvent. Plus inquiétant encore : quand on demande à Mythos 5.2 de faire exprès de moins bien réussir sans que cela se voie, il parvient environ une fois sur quatre à tromper l’outil chargé de surveiller son raisonnement. Aucun n’y était arrivé avant lui.
Autrement dit, ses bons résultats s’expliquent peut-être en partie par le fait qu’il sait repérer quand il passe un examen. Pourtant, Anthropic affirme que le risque de comportement dangereux et contraire à ses directives continue d’être « faible ». Néanmoins, il se contredit presque dans la foulée en avouant que ces évaluations pourraient être remises en question et qu’il n’existe actuellement aucun test capable de détecter toutes les défaillances potentielles d’une IA avant sa mise en service. Pas franchement rassurant.
Le risque change de nature
D’autres signaux méritent l’attention. À commencer par les comportements à risque que Mythos 5.2 peut adopter lorsqu’il croit, à tort et sans justification, qu’il évolue dans une simple simulation. Sur ce critère, il fait légèrement moins bien qu’Opus 5.5 et ne progresse guère par rapport à Mythos 5.1. Or ce danger n’a rien de théorique. En juillet dernier, Anthropic a admis que trois incidents avaient eu lieu lors de tests de cybersécurité de type « capture the flag ». En raison d’un défaut d’isolation des environnements de test, plusieurs modèles Claude avaient accédé au véritable Internet et compromis les systèmes de trois entreprises, persuadés de participer à une simulation. Plus troublant encore, Mythos 5 avait publié sur le dépôt public PyPI un paquet Python malveillant, installé ensuite sur quinze systèmes externes. L’opération avait même permis de récupérer les identifiants d’une entreprise de cybersécurité et d’accéder à sa base de données. Preuve qu’une IA peut poursuivre sa mission jusqu’à provoquer des dommages, sans reconnaître (ou, pire, sans vouloir reconnaître) qu’elle agit dans le monde réel.
Restent les deux seuils de risque majeurs. Selon Anthropic, Mythos 5.2 n’atteint pas le seuil « CB-2 ». Ce dernier correspond à la conception d’armes chimiques et biologiques évoluées, voire inédites. Ses progrès sont modestes par rapport à Opus 5.5 et Mythos 5.1, et les équipes de red teaming ont estimé que ses idées étaient très banales.
Il reste également sous le seuil « Autonomy-2 », seuil qui serait atteint dans deux cas identifiés : premièrement si l’IA se révèle capable de remplacer l’ensemble de l’équipe de recherche à un coût compétitif, ou, secondement, si elle engendre une accélération significative des progrès de l’IA. Anthropic a déjà indiqué que ses modèles frontières contribuaient désormais à 90 % au code des versions en cours de développement. Mais sans réelle autonomie. Et Mythos 5.2 paraît encore assez loin de pouvoir remplacer les chercheurs expérimentés.
En revanche, l’accélération semble plus problématique et son seuil plus proche d’être franchi. L’indicateur interne (AECI) est d’environ 1,88, juste sous la limite de 2. Mais avec une marge d’erreur allant de 1,62 à 2,28 ! En clair, on frôle la ligne rouge. Et, histoire d’ajouter à l’inquiétude générale, l’éditeur qualifie lui-même cette évaluation d’insuffisamment fiable et précise. Et il prévient que cette imprécision s’aggravera à chaque nouvelle amélioration. C’était d’ailleurs l’un des points d’inquiétude relevés par Dario Amodei en septembre dans son célèbre billet.
Quant aux évaluateurs externes (l’AI Security Institute britannique, Frontier Design et METR), ils ont bien testé le modèle mais n’ont relu ni l’annonce ni la System Card. Et n’ont pas non plus, de leur côté, publié ouvertement de verdicts.
DSI et RSSI doivent retenir que les modèles frontières ont désormais fini de repousser les frontières. Ils sont sur le point de les franchir. L’inquiétude ne tient donc pas tant à ce qu’ils peuvent faire qu’à notre capacité à mesurer l’écart entre ce qu’ils montrent en test et ce qu’ils feront en production, au moment même où on leur confie des flottes de plus de mille sous-agents travaillant des jours durant.
De quoi braquer à nouveau les projecteurs sur l’une des urgences absolues de l’agenda déjà chargé des DSI : mettre en place les contrôles ! Identité et supervision des agents, moindre privilège, journalisation, bacs à sable solides, boutons Stop…
À LIRE AUSSI :
À LIRE AUSSI :
À LIRE AUSSI :