Cloud
Un Cloud en pleine guerre : le jour où le multi-AZ d’AWS a cessé de suffire
Par Laurent Delattre, publié le 23 septembre 2026
Six mois après les premières frappes contre ses infrastructures au Moyen-Orient, AWS vient d’admettre l’impensable : certaines données de ses clients ne pourront jamais être restaurées. Au Bahreïn, les dégâts ont dépassé ce que ses architectures régionales et multi-AZ étaient conçues pour supporter. La guerre vient brutalement de rappeler aux DSI que le cloud reste constitué de bâtiments, de câbles, de disques… et de contrats. Et il y a des leçons à en tirer !
Le 15 septembre dernier, AWS a officiellement reconnu l’impensable : le leader du cloud n’est pas en mesure de restaurer les ressources et données hébergées exclusivement dans sa région de Bahreïn, me-south-1. Même constat pour mec1-az2, l’une des Availability Zones de sa région des Émirats arabes unis.
L’aveu est lourd. Au Bahreïn, explique AWS, les dommages ont touché plusieurs Availability Zones et dépassé ce que ses services régionaux et multi-AZ étaient conçus pour encaisser.
Dit autrement, la redondance, cette fois, n’a pas suffi !
Quand la guerre frappe le cloud
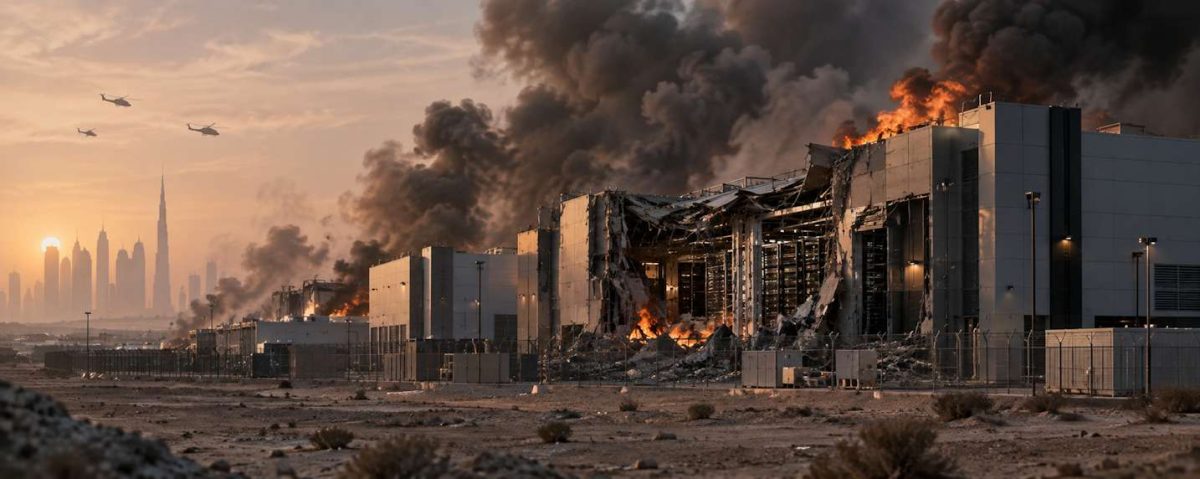
L’histoire commence en mars 2026, lorsque des installations AWS aux Émirats arabes unis et au Bahreïn sont touchées dans le cadre du conflit impliquant l’Iran, les États-Unis et Israël. Aux dégâts directs s’ajoutent incendies, coupures électriques et dommages provoqués par les systèmes d’extinction.
De nouvelles perturbations suivent dans les jours qui suivent. AWS suspend alors la facturation de certains services touchés et prévient que la reconstruction prendra des mois.
Six mois plus tard, le diagnostic change de nature. On ne parle plus d’une indisponibilité prolongée, mais de ressources devenues irrécupérables.
Et soudain, ce qui n’était qu’un incident collatéral d’une guerre lointaine se transforme en avertissement pour toute l’industrie.
À qui la faute ?
La responsabilité de la destruction physique relève évidemment du conflit militaire. Mais AWS reste responsable de l’architecture et des mécanismes de résilience de son cloud.
Le groupe a bâti une grande partie de sa réputation sur ses Availability Zones : des infrastructures séparées, indépendantes en matière d’alimentation et de réseau, conçues pour empêcher qu’une panne locale ne mette toute une région à genoux.
Mais AWS n’a jamais promis qu’une région résisterait à une succession de frappes touchant plusieurs sites. Peut-être même, le leader du cloud n’avait même jamais imaginé ce scénario crédible. Mais prudent, sa documentation recommande depuis longtemps des architectures redondantes multi-régions de sorte à couvrir la disparition simultanée de plusieurs AZ dans le cas notamment d’un événement majeur étendu, comme un tremblement de terre ou une tempête affectant toute une région.
Cette recommandation est aussi un moyen de « refourguer la patate chaude », comprenez retransférer la responsabilité au client dans le cadre de ce fameux piège qu’est la responsabilité partagée du Cloud.
Une application basiquement répartie sur trois « AZ » reste hébergée dans une seule et même région. Si aucune copie n’existe ailleurs, sa résilience s’arrête aux frontières physiques de cette région. Et la responsabilité d’AWS aussi. Et si cette région se retrouve éradiquée de la carte numérique par une guerre ou un tremblement de terre, tout est alors irrémédiablement perdu. Pour survivre à un tel apocalypse, il faut avoir entrepris et adopté une résilience multi-région pas si simple à mettre en œuvre et généralement onéreuse.
Et qui va payer ?
AWS paiera évidemment la reconstruction, les migrations, les crédits consentis aux clients et le coût réputationnel de l’incident.
Mais les entreprises qui imaginent pouvoir lui présenter la facture de leurs données perdues risquent une désillusion.
Les contrats standards d’AWS classent la guerre parmi les événements de force majeure. Les SLA excluent par ailleurs les événements situés hors du contrôle raisonnable du fournisseur et les limitations de responsabilité protègent largement AWS contre les pertes indirectes, les pertes de revenus ou la valeur des données perdues.
Certains grands comptes disposent évidemment de contrats négociés différemment. Pour les autres, le message est limpide : un SLA n’est pas une assurance tous risques du système d’information.
Le vrai échec d’AWS
Dire qu’AWS a échoué parce que ses datacenters n’ont pas résisté à une guerre serait trop facile. Le groupe documente depuis longtemps la différence entre haute disponibilité multi-AZ et reprise après sinistre multi-région.
L’échec est surtout celui de l’abstraction du cloud.
Pendant quinze ans, les hyperscalers ont réussi à faire oublier les bâtiments derrière les API. Une région est devenue une valeur dans une console, une Availability Zone quelques caractères dans Terraform.
La guerre vient de brutalement remettre la géographie dans l’équation.
Et pour AWS, le symbole est cruel : l’entreprise qui a largement popularisé l’Availability Zone vient de rappeler à tous ses clients qu’une région cloud possède, elle aussi, une frontière physique.
Les 5 leçons que les DSI doivent en retenir
Leçon 1 : Multi-AZ ne veut définitivement pas dire multi-région
Le rappel est brutal et la leçon n’aurait jamais du pouvoir être oublée. Deux machines dans deux AZ peuvent survivre à la perte d’un datacenter. Trois AZ peuvent absorber quantité de catastrophes locales. Mais toutes appartiennent toujours à la même région. Pour chaque application réellement critique, la question que tout DSI doit se poser est « Que se passe-t-il si cette région disparaît demain matin ? »
AWS recommande le multi-région lorsque la perte simultanée de plusieurs AZ fait partie du scénario de risque.
Leçon 2 : Une réplication ne vaut pas une sauvegarde
Une base répliquée sur plusieurs AZ améliore énormément sa disponibilité. Elle ne garantit pas sa survie si toutes ses copies appartiennent au même domaine de défaillance. Et une réplication multi-région ne protège pas davantage d’une suppression accidentelle ou d’une corruption immédiatement répliquée.
Tous les DSI et RSSI savent qu’il faut superposer les mécanismes : réplication, snapshots, sauvegardes immuables et copies dans une autre région, voire chez un autre fournisseur ou hors cloud lorsque le risque le justifie.
AWS recommande d’ailleurs explicitement de sauvegarder les données du site de secours en plus de leur réplication. Et de le faire quand c’est possible dans une autre région ou hors Cloud.
Leçon 3 : La souveraineté peut être un piège géographique
Certaines entreprises concentrent volontairement leurs données dans une région pour respecter des contraintes réglementaires, contractuelles ou de souveraineté.
Mais cet incident dévoile brutalement l’autre face du problème. Imposer qu’une donnée ne quitte jamais un territoire peut signifier qu’aucune copie de secours ne peut échapper à une catastrophe frappant ce territoire.
Il faut donc penser simultanément résidence des données et résilience des données. Ce qui impose de trouver une deuxième région juridiquement autorisée, d’externaliser les sauvegardes, de réfléchir au-delà du cloud de confiance, d’évaluer les scénarios de rapatriement sur des infrastructures internes, et surtout d’imaginer comment combiner ces options.
La souveraineté sans scénario de continuité peut vite ressembler à un « SPOF » (Single Point of Failure ou point unique de défaillance) réglementaire.
Leçon 4 : Un PRA jamais basculé reste une présentation PowerPoint
AWS propose quatre grandes approches multi-région : backup/restore, pilot light, warm standby et active-active. Elles correspondent à des RTO, des RPO et surtout à des budgets très différents.
Mais posséder des sauvegardes dans une seconde région n’est qu’un début. Il faut aussi vérifier que le DNS bascule, que les identités fonctionnent, que les secrets et clés de chiffrement sont accessibles, que les images et artefacts applicatifs demeurent toujours accessibles, que les réseaux peuvent être reconstruits et que la capacité nécessaire au fonctionnement sera réellement disponible.
Et il faut essayer. Régulièrement.
Leçon 5 : Le risque géopolitique entre dans l’architecture cloud
Lorsqu’un DSI choisit une région cloud, il compare généralement la latence, le catalogue de services, le prix et la réglementation. Il va désormais falloir ajouter beaucoup plus explicitement le risque physique et géopolitique. Les DSI le vivent depuis le début de l’année 2025. La géopolitique s’est inscrite à leur agenda. Et le cloud n’y échappe évidemment pas.
Ce qui, forcément, doit aussi conduire les DSI à relire trois documents rarement passionnants : le SLA, les clauses de force majeure et les limites de responsabilité de leur fournisseur de Cloud.
L’incident AWS vient en effet de nous rappeler qu’externaliser les serveurs ne signifie pas externaliser le risque.
Le cloud permet de déplacer ce risque, de le mutualiser et de le réduire spectaculairement. Mais il ne l’abolit nullement.
Et lorsqu’une guerre atteint directement les datacenters, même le fameux « nuage » finit par toucher le sol ! Nous, les Gaulois, sommes bien placés pour le savoir…
À LIRE AUSSI :
À LIRE AUSSI :