Data / IA
Jev, le modèle IA qui fait le Buzz sans savoir écrire
Par Laurent Delattre, publié le 21 septembre 2026
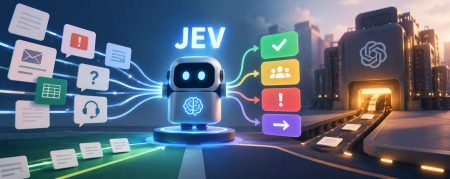
Imaginez un logiciel qui doit répondre 100 000 fois par jour à des questions comme : « fraude ou pas fraude ? », « escalade ou pas ? », « ce ticket concerne-t-il la facturation ? ». Aujourd’hui, certaines architectures envoient ces questions à GPT-6 ou Claude. C’est un peu prendre un semi-remorque pour aller chercher une baguette. Et c’est exactement ce Jev veut éviter… Un nouveau modèle qui fait le Buzz mais qui préfigure surtout la fin du « tout LLM »…
Lancé mi-septembre par la jeune pousse TypeSafe AI, Jev ne rédige rien. Et pourtant ce modèle agite tout l’écosystème IA depuis son annonce. Le pedigree de son fondateur y est probablement pour beaucoup : Diogo Almeida a participé chez OpenAI à la mise au point du RLHF et d’InstructGPT, les travaux qui ont rendu ChatGPT possible.
Mais la vraie raison de cette agitation est aussi ailleurs : Jev présente une alternative étonnamment simple, peu onéreuse et rapide face aux LLM sur certains cas d’usage. Sa conception est le fruit d’une intuition assez difficile à contester : toutes les tâches confiées à un LLM n’ont pas besoin d’un modèle génératif !
Dans les workflows métiers et, de plus en plus, dans les systèmes agentiques, un logiciel ne demande pas toujours à l’IA de générer une réponse complexe mais lui demande souvent des milliers de petites décisions : déterminer si un document est pertinent, choisir une catégorie, évaluer un risque, router une requête ou décider s’il faut passer la main à un humain.
Jev est conçu exclusivement pour cela : prendre une décision rapide et pertinente. Il reçoit un « état » (texte, données métiers, contexte d’un incident…), puis choisit entre des réponses définies à l’avance, avec un score ou une probabilité associée.
TypeSafe présente cette approche comme une nouvelle catégorie, les « System One Models », en référence au « système 1 » de Daniel Kahneman, la pensée rapide et intuitive, par opposition au « système 2 », lent et délibéré.
La startup affirme avoir développé pour cela une architecture spécifique, un nouvel échantillonneur parallèle et une méthode d’entraînement baptisée RLCD (Reinforcement Learning for Calibrated Decisions).
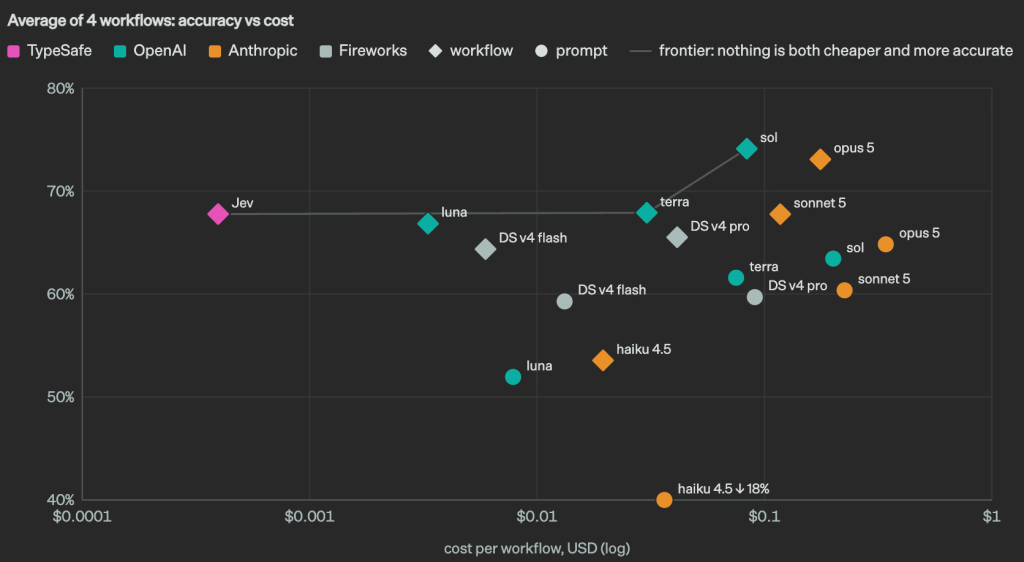
Avec à la clé quelques atouts et métriques qui interpellent : 70 à 500 ms de latence annoncée, 0,042 dollar par million de tokens d’entrée (contre 0,20$ à 10$ pour les LLM), aucun coût en sortie, plusieurs décisions évaluées en parallèle, et surtout des probabilités censées être suffisamment calibrées pour piloter des seuils d’automatisation. TypeSafe revendique même, sur ses propres benchmarks, jusqu’à 193,6 fois moins de temps de traitement et 444,6 fois moins de coûts qu’avec certains grands modèles génératifs. Des chiffres spectaculaires, mais obtenus en conditions optimales.
Une révolution ? Pas tout à fait…
L’idée est pertinente. Mais beaucoup moins révolutionnaire que le discours de TypeSafe ne le suggère.
Classifier un texte, attribuer un score ou choisir entre plusieurs catégories existe depuis longtemps. Les grands LLM savent déjà le faire, notamment via les sorties structurées qui garantissent qu’un modèle respecte un schéma imposé. Preuve en est, TypeSafe a publié sous licence MIT un projet baptisé System One Adapter. Son rôle ? Reproduire l’interface de Jev… en utilisant des LLM OpenAI ou Anthropic. Un outil conçu à la base pour permettre à TypeSafe de comparer Jev avec ses concurrents. Et ainsi justifier la pertinence de Jev. La thèse défendue par la startup n’est pas que les LLM en sont incapables, mais qu’ils le font trop lentement, trop cher, et sans savoir dire quand ils se trompent.
Même le « zéro hallucination » revendiqué par TypeSafe mérite un sérieux astérisque. Jev peut garantir qu’il répondra FRAUDE, NORMAL ou À_VERIFIER et rien d’autre. Mais il peut toujours choisir FRAUDE lorsque la bonne réponse était NORMAL. Il ne supprime pas l’erreur. Il supprime essentiellement la possibilité de sortir du cadre fixé par le programme. La startup le concède d’ailleurs à demi-mot : le 0 % d’hallucination affiché sur ses graphiques n’est pas mesuré, il découle juste du fait que Jev ne peut pas sortir des réponses imposées.
La véritable originalité de Jev est donc ailleurs. D’abord, la classification et donc le fait d’avoir construit un modèle entier autour de cette limitation volontaire, plutôt que demander à un modèle généraliste de se comporter comme un classifieur.
Ensuite, et surtout, la calibration : chaque réponse s’accompagne d’une probabilité censée refléter sa fiabilité réelle. Un LLM sait respecter un schéma, mais il se montre souvent trop sûr de lui. Or c’est précisément cette capacité à mesurer le doute qui permet d’automatiser : laisser la machine agir seule au-dessus d’un certain seuil de confiance, passer la main à un humain en dessous de ce seuil.
Enfin, le parallélisme : poser dix questions sur un même ticket ne prend guère plus de temps qu’en poser une. Si ces promesses se vérifient hors des benchmarks maison, l’avantage est bien réel.
Autre fragilité qui doit interpeler les DSI : Jev n’est pas open source. TypeSafe publie ses SDK et certains outils, mais pas les poids ni l’architecture détaillée du modèle. Pour une brique destinée à s’enfouir profondément dans les workflows métiers, cette dépendance mérite d’être examinée de près d’autant que, pour l’instant, Jev n’est hébergé que sur des serveurs américains. Signalons au passage que l’accès à Jev n’est qu’en preview et passe pour le moment par une liste d’attente.
Autre remarque : TypeSafe ne révèle ni le nombre de paramètres de Jev, ni le détail de son architecture. Impossible donc de savoir si ses performances spectaculaires viennent d’un modèle radicalement plus petit, d’une architecture très différente des LLM traditionnels, ou d’une combinaison des deux.
Entre classifieur et LLM, Jev cherche sa place
Alors, Jev a-t-il un avenir ? Probablement. Mais peut-être pas celui que TypeSafe imagine.
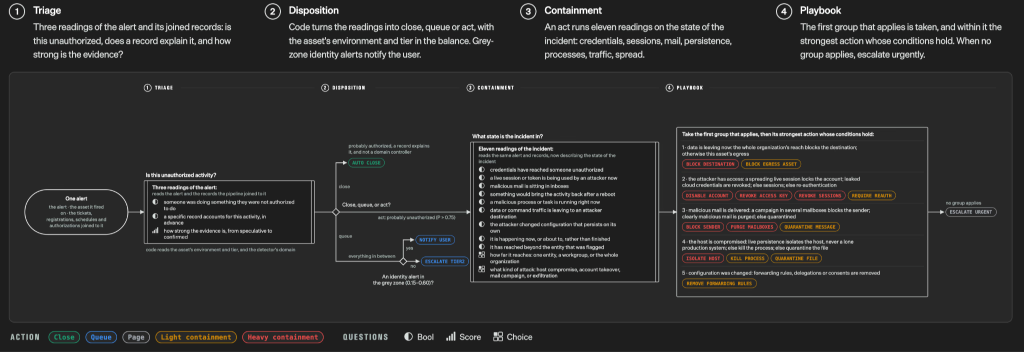
Certes, le cas d’usage existe clairement. À mesure que les agents se multiplieront, les logiciels auront besoin de millions de microdécisions intelligentes : router, filtrer, scorer, vérifier, autoriser, interrompre, escalader.
Il paraît économiquement absurde de confier systématiquement chacune d’elles au modèle le plus puissant disponible.
Mais Jev se retrouve pris entre deux concurrents.
Par le bas, les petits modèles, les classifieurs traditionnels et les modèles open source peuvent déjà traiter une partie de ces tâches à très faible coût.
Par le haut, GPT, Claude, Gemini et les autres grands modèles savent déjà produire des décisions structurées et leurs fournisseurs peuvent progressivement optimiser cette fonction.
Ce qui limite Jev à un espace très précis : les problèmes trop sémantiquement complexes pour un petit classifieur, mais trop simples pour justifier le prix et la latence d’un grand LLM.
L’espace existe, il est probablement vaste. Il est néanmoins balisé aussi par les limites propres à Jev : une fenêtre de contexte de 32 000 tokens, et une précision qui se dégrade dès que le contexte fourni s’encombre d’informations sans rapport avec la décision. TypeSafe recommande d’ailleurs de découper toute question complexe en questions simples (avec un LLM ?), puis de recombiner les réponses dans le code.
Mais Jev ne remplace pas les LLM. Il les complète en prenant en charge les microdécisions simples, répétitives et structurées pour lesquelles mobiliser un grand modèle génératif serait inutilement coûteux et lent. TypeSafe met d’ailleurs en avant un usage révélateur : noter, vérifier et filtrer les prompts comme les réponses des LLM, jusqu’à détecter les tentatives de jailbreak ! Jev en garde-fou des grands modèles plutôt qu’en concurrent, amusant non ?
Finalement, son meilleur scénario commercial est aussi son plus grand risque : avoir identifié un besoin suffisamment important pour que toute l’industrie décide de le copier.
Et si le vrai bouleversement était ailleurs ?
L’arrivée de Jev éclaire de nouvelles perspectives pour réduire la facture de l’IA agentique et invite les DSI et les développeurs à porter un nouveau regard sur la création de leurs agents IA.
Il va vite paraître indispensable de cartographier tous les endroits où les applications utilisent aujourd’hui un LLM simplement pour prendre une décision.
Et une nouvelle ère s’ouvre : après avoir cherché à mettre des LLM partout, il va devenir urgent de repérer tous les endroits où l’on peut s’en passer. C’est un changement, à contresens des derniers mois, mais probablement salutaire.
Reste une jolie ironie, assumée jusque dans le nom du modèle. Jev rend hommage à William Stanley Jevons, l’économiste britannique qui observait dès le XIXᵉ siècle qu’améliorer l’efficacité des machines à vapeur ne réduisait pas la consommation de charbon… mais la faisait au contraire exploser. TypeSafe parie sur le même paradoxe avec l’IA : si chaque microdécision devient quasi instantanée et presque gratuite, les entreprises ne vont pas en prendre autant pour moins cher. Elles vont surtout en prendre des millions de plus. Jev ne promet donc pas forcément de faire fondre la facture de l’IA. Il pourrait surtout contribuer à la déplacer, en transformant ce qui était encore une ressource coûteuse en une commodité consommée sans compter.
À LIRE AUSSI :
À LIRE AUSSI :