Green IT
TOP500 : la Chine conserve sa couronne, mais la bataille du calcul est ailleurs
Par Laurent Delattre, publié le 18 novembre 2026
Le Top 10 ne bouge plus. La Chine garde la tête, la France son doublé énergétique, mais les nouveaux entrants se raréfient. Derrière ce palmarès figé, l’IA redessine les priorités du supercalcul et rend ces TOP500 et GREEN500 d’automne 2026 moins instructifs.
La liste de juin dernier avait créé un petit séisme en officialisant non seulement le grand retour de la Chine dans le TOP500, palmarès semestriel des 500 supercalculateurs les plus puissants de la planète, mais aussi et surtout son arrivée directe en tête, avec le premier HPC brisant officiellement le plafond des 2 exaflops !
Le cru d’automne, publié cette semaine, confirme celui du printemps. Une stabilité qui inquiète et qui en dit aussi long sur les transformations actuelles en matière d’architectures de calcul à haute performance et d’investissement.
Car cette 68e édition n’accueille que 27 nouveaux venus, soit 5,4 % des systèmes classés : un plus bas historique ! À l’heure où les investissements dans les infrastructures d’IA s’envolent et où les hyperscalers ne cherchent même plus à y défendre leur place, le supercalcul marque-t-il juste une pause ou est-ce que la course à la puissance se joue désormais ailleurs ?
LineShine reste devant, sans creuser l’écart
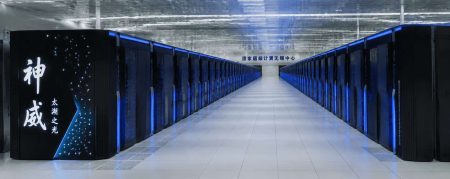
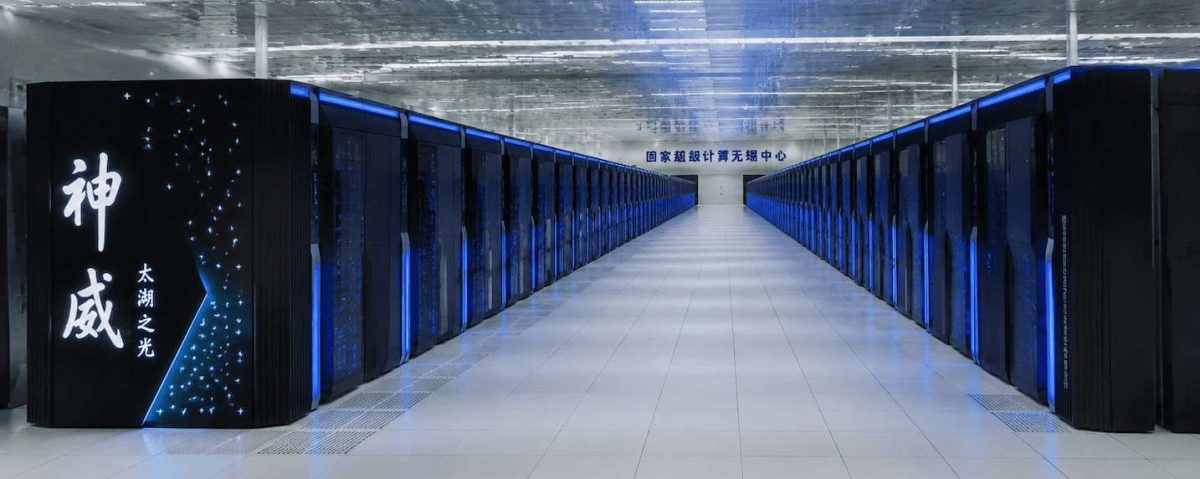
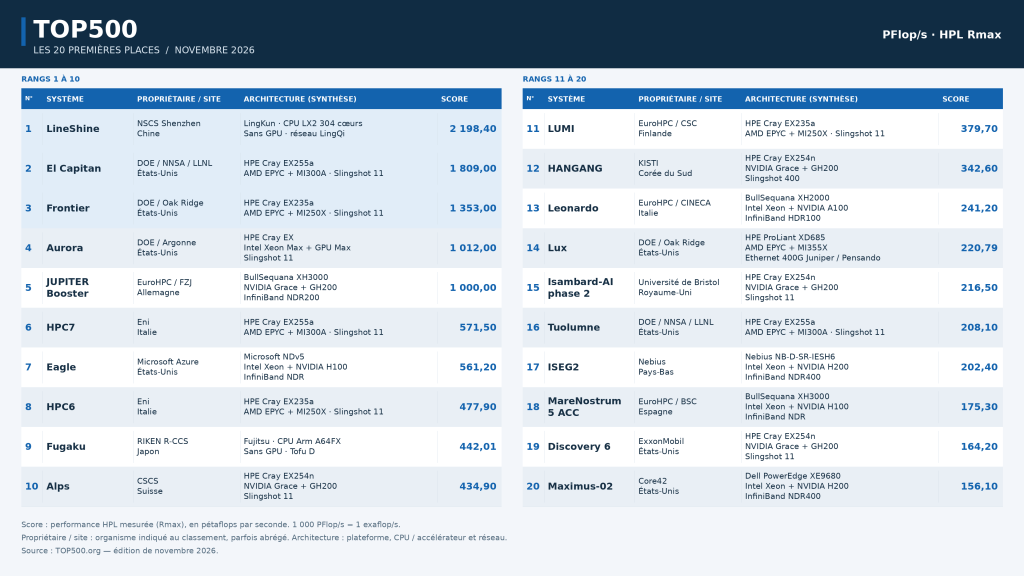
Le supercalculateur de Shenzhen conserve sa médaille d’or, avec des caractéristiques et des résultats identiques à ceux de juin. Avec ses 13,79 millions de cœurs, LineShine affiche 2,198 exaflops au test HPL (High Performance Linpack, la mesure de référence du TOP500), pour 2,736 exaflops théoriques. Son avance sur le n° 2 demeure d’environ 22 %.
LineShine repose sur la plateforme matérielle LingKun, articulée autour de processeurs LX2 de 304 cœurs et de l’interconnexion à haut débit LingQi, qui relie les nœuds de calcul. Côté logiciel, le système d’exploitation maison Kylin OS, basé sur Linux, fournit un compilateur C++ Lclang, des bibliothèques OpenBLAS adaptées pour accélérer le calcul matriciel et une version d’OpenMPI personnalisée pour LingQi, qui coordonne les échanges entre les programmes répartis sur les nœuds.
Ce qui surprend le plus, c’est l’absence de GPU. Toute la puissance de calcul est ici fournie par des CPU (plutôt monstrueux avec leurs 304 cœurs chacun) dont le fabricant reste incertain : Huawei est souvent cité, mais le LX2 est officiellement une production du Shenzhen Cloud Computing Center. Ce choix du tout-CPU se traduit par une facture énergétique assez effroyable : 42,22 MW déclarés pour LineShine, contre 29,685 MW pour El Capitan, le système américain à GPU classé n° 2.
Autre interrogation, la Chine n’a-t-elle vraiment qu’un supercalculateur exaflopique ? Très probablement pas. En fin stratège politique, la Chine cherche surtout à utiliser ce TOP500 pour servir sa propagande, sans dévoiler son potentiel réel. Depuis plusieurs années, deux autres systèmes, le Sunway OceanLight et le Tianhe-3, sont décrits comme ayant franchi le seuil exaflopique, sans avoir soumis leurs résultats au TOP500. Des publications scientifiques et académiques attestent notamment de calculs mobilisant quelque 42 millions de cœurs sur la nouvelle génération Sunway, sans qu’on puisse pour autant en déduire ses performances sur HPL.
Surtout, cet été, Sugon (un constructeur chinois de serveurs et de supercalculateurs) a annoncé l’achèvement de Sugon 8000, alias Dengfeng, un cluster de 100 000 cartes associant calcul scientifique et IA, construit autour de composants chinois, notamment signés Hygon (un concepteur chinois de processeurs et d’accélérateurs de calcul). Faute de benchmark, impossible de situer Dengfeng face à LineShine. Une certitude néanmoins, la vitrine du TOP500 ne montre qu’une fraction du parc chinois. Car avec LineShine, Pékin a finalement fait passer l’essentiel : une machine entièrement souveraine peut devancer les Américains en double précision malgré les restrictions à l’export. Message bien reçu, merci.
Les États-Unis marquent le pas et misent sur l’IA scientifique
Derrière LineShine, on retrouve le trio du DOE (Département américain de l’Énergie) : El Capitan (1,809 exaflops) au Lawrence Livermore National Laboratory, Frontier (1,353 exaflops) à Oak Ridge et Aurora (1,012 exaflops) à Argonne, tous trois bâtis sur la plateforme HPE Cray EX et son interconnexion Slingshot-11. Les trois systèmes américains demeurent exascale, sans progression de leur score HPL dans cette édition.
Un petit bémol quand même. Si la Chine conserve la tête sur le benchmark HPCG, les USA conservent leur leadership sur le benchmark en précision mixte, HPL-MxP, avec un El Capitan affichant une performance de 16,7 exaflops (devant Aurora à 11,6 et Frontier à 11,4, LineShine restant quatrième avec 7,92 exaflops).
Souvent présenté comme un bench « HPC pour l’IA », HPL-MxP demeure un test de calcul numérique, pas un test complet d’entraînement ou d’inférence. Il éclaire l’intérêt de la précision mixte et les performances des machines dans ce domaine, mais ne désigne pas à lui seul le meilleur système pour l’IA.
Les États-Unis ne reprennent donc pas la tête, et ce n’est pas le nouveau « Lux » d’Oak Ridge qui pouvait changer la donne : il n’a jamais prétendu au trône. Sa mission : faire travailler ensemble simulation scientifique et IA, en produisant des données avec les modèles physiques, puis en les exploitant pour entraîner des modèles et accélérer les recherches. Ses GPU AMD MI355X sont taillés pour ces usages, avec une puissance annoncée de 20 exaflops pour l’entraînement en FP8, contre environ 317 pétaflops en calcul scientifique classique. Encore en construction, Lux fait bien son entrée au TOP500, mais au 14e rang seulement, avec 220,79 pétaflops pour l’instant. Ce système HPE ProLiant XD685 associe à ses GPU des processeurs AMD EPYC, un réseau Pensando et l’environnement ROCm. Rien d’un supercalculateur traditionnel.
Lux est le premier système opérationnel de la « Genesis Mission », le programme du DOE qui entend mettre l’IA au service de la découverte scientifique. La moitié de ses 3,5 millions d’heures-nœuds annuelles est réservée à ce programme, l’autre moitié étant louée à des partenaires publics et privés. Conçu sur un modèle hybride, mi-centre de calcul national, mi-cloud (en partenariat avec Oracle Cloud Infrastructure), il préfigure Discovery, le prochain fleuron d’Oak Ridge attendu en 2028 avec les GPU MI430X et les processeurs EPYC « Venice ». Ce successeur de Frontier vise des applications scientifiques trois à cinq fois plus rapides, mais sa puissance totale et son futur score au TOP500 restent inconnus.
La vraie surprise, par son absence, est à chercher du côté du Doudna. Le futur supercalculateur du NERSC, construit par Dell sur la plateforme NVIDIA Vera Rubin, manque encore à l’appel. Pourtant, son système d’accès anticipé, baptisé Cech, a été livré en janvier, et Berkeley Lab visait encore en mars une mise en production fin 2026. Il faudra sans doute attendre juin pour mesurer ce que Vera Rubin a dans le ventre sur HPL.
L’Europe confirme ses acquis, sans nouveau bond au sommet
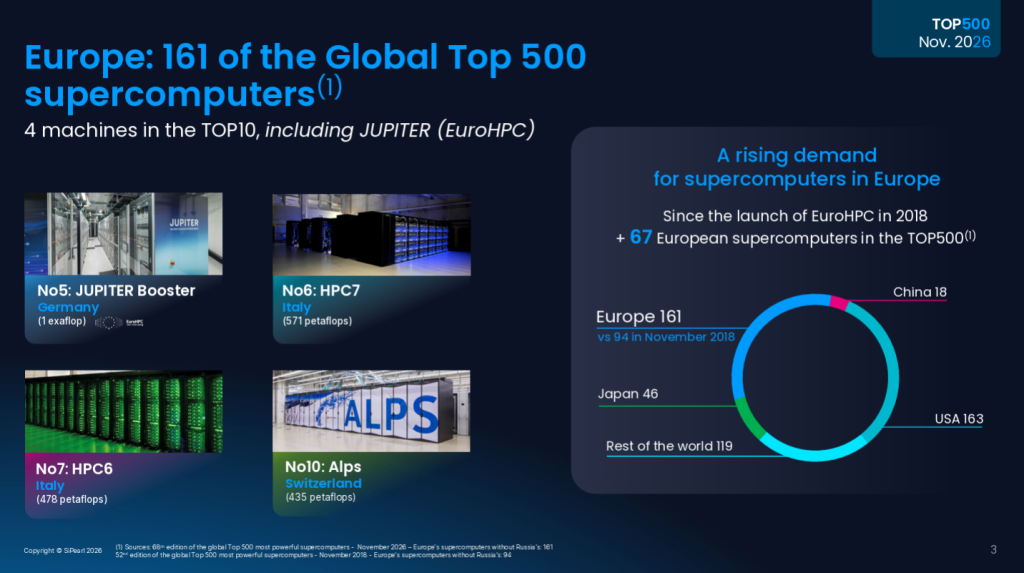
L’Europe figure toujours dans le Top 5. Le JUPITER « Booster Module » conserve sa cinquième place avec exactement un exaflop. Le résultat publié ne matérialise donc pas, à ce stade, le nouveau bond dans la hiérarchie que pouvait laisser espérer la poursuite du projet. Il faut dire que la partie « Cluster Module » attend toujours les livraisons massives du processeur Rhea1 de SiPearl, que Bull a à peine commencé à recevoir. Bâti sur des lames BullSequana XH3000, le Cluster Module offrira une partition purement CPU de plus de 1 300 nœuds, destinée aux tâches les plus gourmandes en mémoire.
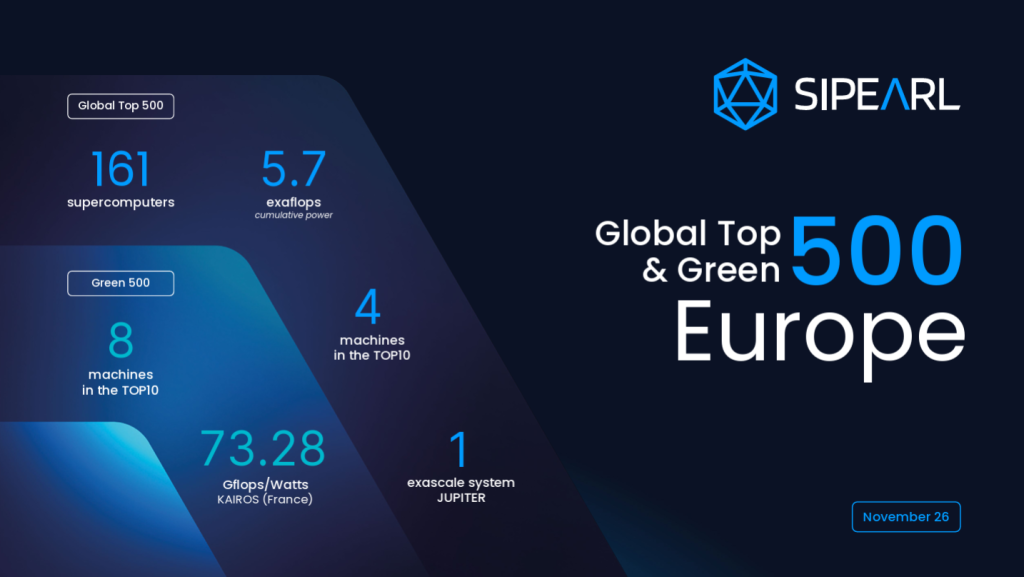
L’Europe « géographique » conserve néanmoins quatre représentants dans le Top 10, trois étant hébergés dans l’Union européenne. Outre JUPITER, on retrouve les deux systèmes industriels du pétrolier italien Eni, HPC7 (6e, 571,5 pétaflops) et HPC6 (8e, 477,9 pétaflops), ainsi que le suisse Alps (10e, 434 pétaflops) au CSCS.
Les HPC LUMI (11e, 379 pétaflops) et Leonardo (13e, 241 pétaflops) restent aux portes du Top 10.
Alice Recoque, la deuxième machine exaflopique achetée par EuroHPC, est, pour sa part, à peine en cours d’installation au Très Grand Centre de calcul du CEA, à Bruyères-le-Châtel. Le système signé Eviden associera une partition « unifiée » à base de GPU AMD Instinct MI430X et de CPU AMD EPYC « Venice » à une partition « scalaire » animée par le futur Rhea2 de SiPearl. La mise en service de la partition « unifiée » est attendue fin 2027 ou début 2028. La date de mise en service de la partition « scalaire » n’a pas encore été annoncée.
Green500 : le doublé français tient toujours
Mais s’il est un sujet où l’Europe se distingue tout particulièrement, c’est bien celui de l’efficacité énergétique. Outre la performance brute, les responsables du TOP500 publient en effet le Green500, qui ordonne les supercalculateurs selon le nombre d’opérations de calcul réalisées par seconde et par watt consommé lors du test Linpack.
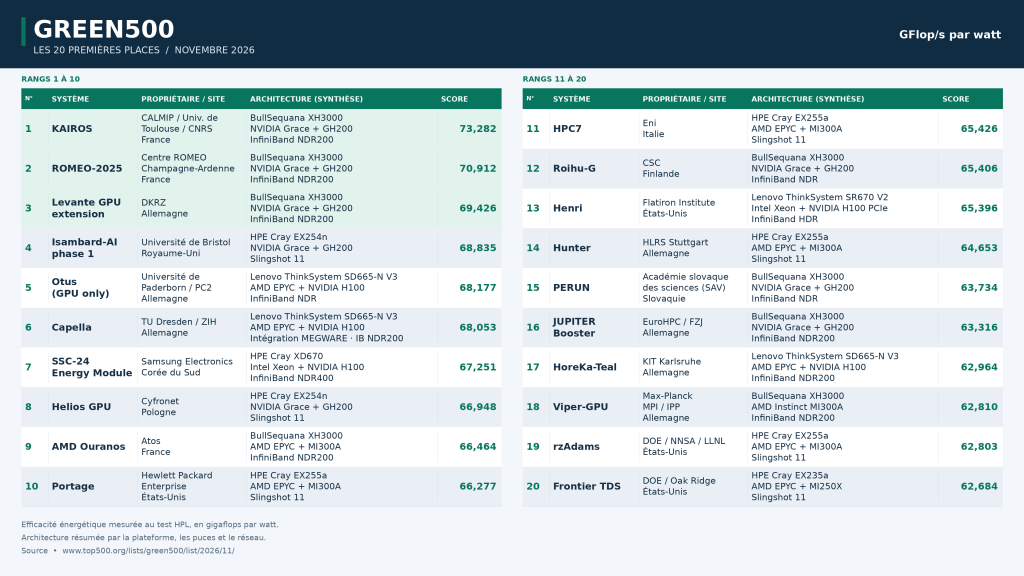
Le HPC KAIROS, au CALMIP de Toulouse, reste premier du Green500 avec 73,28 gigaflops par watt, devant ROMEO-2025, à Reims, avec 70,91. L’extension GPU de Levante, au DKRZ allemand, complète toujours le podium à 69,43. Ces trois systèmes BullSequana XH3000 équipés de NVIDIA GH200 confirment la qualité de l’intégration européenne.
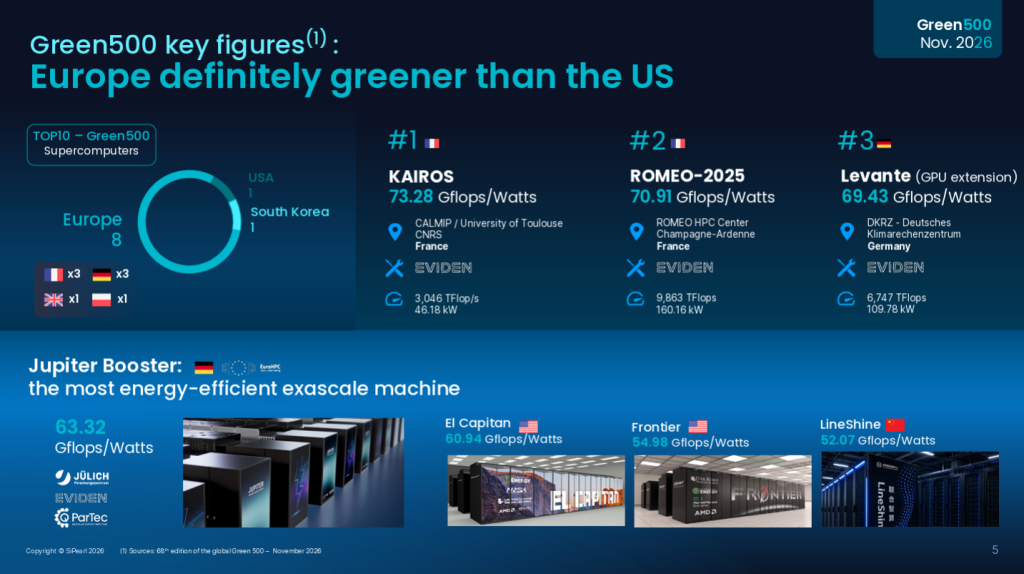
La thèse que nous défendions en juin se vérifie : à technologie égale, les petites installations restent les plus efficaces, les interconnexions pesant davantage dans les grandes. KAIROS ne délivre que 3,046 pétaflops et pointe à la 472e place du TOP500. ROMEO-2025, plus imposant, y perd quelques gigaflops par watt.
Aucun des HPC des 10 premières places du TOP500 ne figure dans les 10 premières places du Green500. Il faut aller à la 11e place pour découvrir le HPC7 d’Eni (6e du TOP500) puis à la 16e place pour retrouver le JUPITER Booster (5e du TOP500), là encore, uniquement des machines européennes.
Un classement moins miroir des réalités
Deux autres éléments de réflexion émergent de ces nouveaux classements.
Le premier, c’est que les géants du cloud ne jugent pas utile de faire tourner le benchmark Linpack sur leurs campus hyperscales. Il est vrai que figurer au TOP500 relève d’un exercice volontaire, porté principalement par des centres académiques, et qu’il engendre des coûts d’immobilisation des machines incompatibles avec les besoins business. On notera que le seul système d’hyperscaler encore classé est Eagle, de Microsoft Azure, qui pointe toujours à la 7e place.
Le second tient à la faiblesse historique du renouvellement. La plus haute nouvelle entrée est sud-coréenne : c’est le HANGANG, au KISTI, qui prend la 12e place du TOP500 avec 342,6 pétaflops (et la 29e place du Green500) et ses super-puces NVIDIA GH200 (un système HPE Cray EX254n).
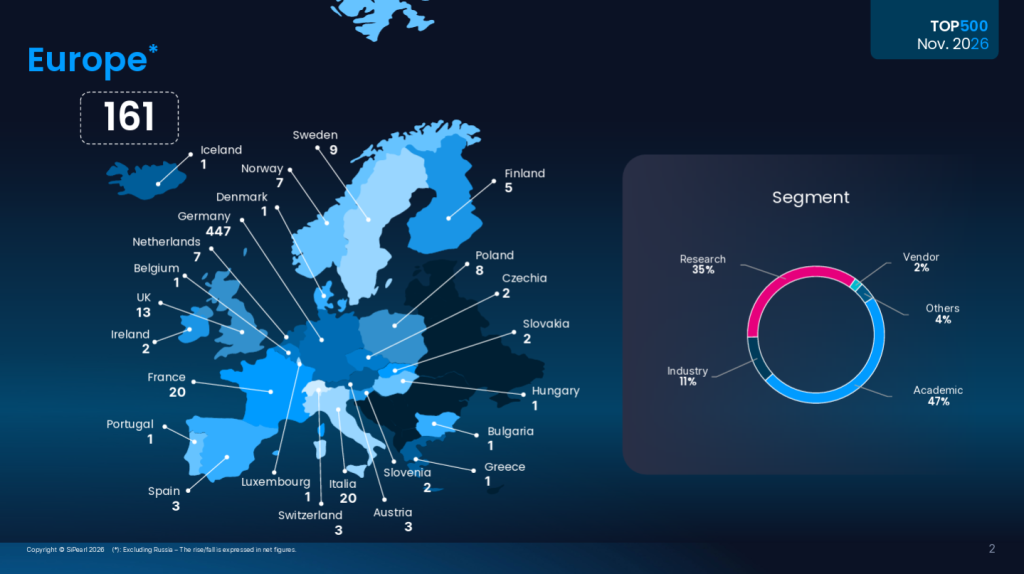
Ces deux réflexions éclairent une même réalité : un déplacement des investissements vers les « AI factories » et non plus les HPC purs et durs. S’appuyant sur les estimations d’Epoch AI, les organisateurs du TOP500 rappellent que les capacités de calcul IA ajoutées chaque trimestre progressent d’environ 2,5 fois par an, que la puissance IA installée dans le monde dépasse l’équivalent de 15 millions de GPU NVIDIA H100, et que cinq hyperscalers américains en détenaient environ 71 % fin 2025. Il serait bienvenu que les organisateurs planchent aussi sur un « AI500 » pour classer les AI factories sur leurs performances réelles en inférence et en entraînement. Ça n’a pas l’air d’être à leur programme pour l’instant.
La bataille NVIDIA vs AMD se poursuit
Et bien sûr, derrière tous ces systèmes, il y a des fournisseurs de CPU et de GPU. Avec deux grands gagnants : NVIDIA et AMD.
NVIDIA poursuit sa progression : 252 des 500 systèmes embarquent désormais des accélérateurs NVIDIA, contre 237 en juin 2026 et 183 il y a deux ans, face à 34 seulement pour AMD. Le haut du Green500 n’ayant pas bougé, NVIDIA y conserve aussi les huit premières places. AMD garde de son côté quatre systèmes dans le Top 10 (El Capitan, Frontier, HPC7 et HPC6), qui pèsent plus de 40 % de la performance HPL cumulée du Top 10.
Et Intel ? Le fondeur ne doit plus sa présence au sommet qu’à Aurora, seule architecture entièrement Intel du Top 10, et aux processeurs Xeon de l’Eagle de Microsoft. Aucun des nouveaux venus du haut du palmarès ne vient prendre le relais.
En définitive, force est de reconnaître que le TOP500 n’est plus un reflet aussi significatif de la course mondiale à la puissance de calcul. Il n’en donne plus qu’un aperçu, instructif mais partiel. L’exascale reste un bon point de départ, mais la sobriété énergétique influence de plus en plus les choix politiques, tout comme la souveraineté des composants (on le voit bien avec la Chine et l’Europe).
La réalité, c’est que la course est aujourd’hui en train de se jouer ailleurs : sur les campus privés des acteurs du cloud qui comptent bien davantage les gigawatts que les exaflops.
À LIRE AUSSI :
À LIRE AUSSI :