Data / IA
.Conf26 : Splunk se réinvente pour l’ère de l’IA agentique
Par Laurent Delattre, publié le 21 septembre 2026
À Denver, la .conf26 a confirmé la mue de Splunk sous pavillon Cisco. L’éditeur qui aspirait tous les logs de l’entreprise renonce à tout centraliser et s’apprête à facturer l’activité plutôt que le volume. Surtout, il se tourne vers une nouvelle population d’utilisateurs : les agents IA. Son ambition est de devenir le registre de ce que font les machines, et de ce qu’elles coûtent. Le pari est cohérent, mais plusieurs questions des DSI restent toujours en suspens.
Deux ans et demi après la finalisation de son acquisition par Cisco, Splunk change de dimension. Le spécialiste de l’analyse des données machine, devenu notamment incontournable dans de nombreux SOC, se voit confier une mission bien plus large : relier réseau, sécurité, observabilité et IA dans un ensemble capable d’agir et de réagir à la vitesse des machines. Et non plus à celle des humains.
Mais attention au raccourci. Splunk ne cherche pas pour autant à devenir une plateforme de données généraliste venant défier frontalement Snowflake, Databricks ou les grands data lakes d’entreprise. Son terrain reste celui de la donnée opérationnelle IT : logs, métriques, traces, événements de sécurité, télémétrie réseau et, désormais, traces d’exécution et consommation des agents IA. Ce qui change radicalement, c’est qu’il ne considère plus nécessaire d’aspirer toutes ces données dans ses propres index pour en tirer de la valeur. Le Splunk de 2026 veut aller les chercher là où elles se trouvent, les contextualiser, les corréler et déclencher une action. Autrement dit, devenir moins un entrepôt qu’un plan de contrôle.
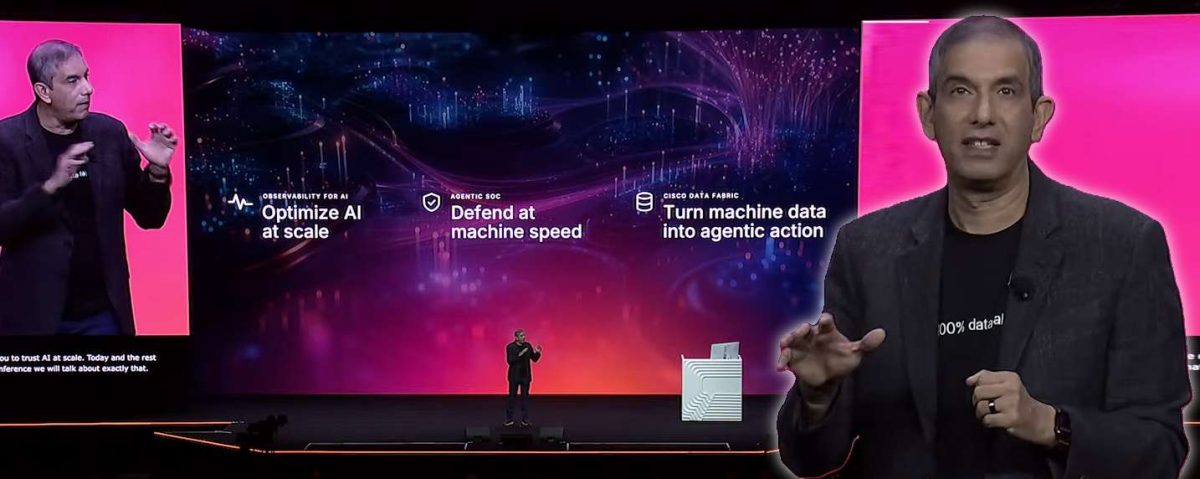
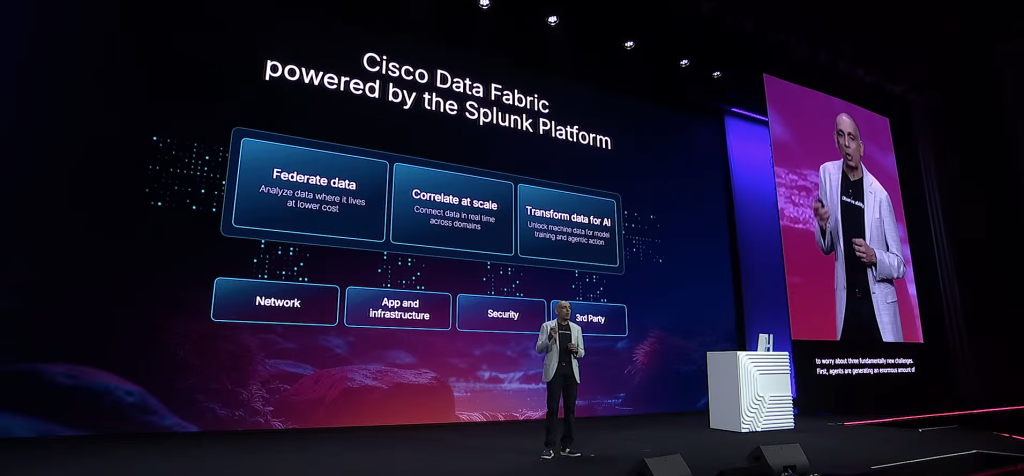
Deux mouvements accélèrent cette transformation. D’un côté, la Cisco Data Fabric organise l’accès à des données de plus en plus distribuées, chez Splunk mais aussi dans AWS, Snowflake, Databricks ou les infrastructures internes des entreprises. De l’autre, l’intégration des technologies de Galileo apporte à Splunk une couche d’évaluation, de surveillance et de gouvernance des modèles et des agents IA, histoire de bien ancrer la plateforme dans l’air du temps et les nouvelles réalités de la DSI.
Année après année, l’editeur dépasse donc sa vocation historique de plateforme d’analyse des données machine pour devenir progressivement l’infrastructure chargée d’observer les machines qui observent les machines. Un positionnement que la .conf26, organisée du 14 au 17 septembre à Denver, a rendu beaucoup plus lisible.
Le Splunk qui aspirait tous les logs appartient au passé
Lors de l’édition 2025, Splunk avait largement commencé à assembler les pièces du puzzle de cette transformation. Machine Data Lake permet de conserver de gros volumes de télémétrie à moindre coût. La recherche fédérée interroge les données qui restent dans d’autres plateformes. Enterprise Security a été remanié autour des éditions Essentials et Premier. Et cet été, Value Insights a ajouté une mesure de la valeur produite par la plateforme tandis qu’Integrated Enterprise Value réduisait le coût d’ingestion de certaines télémétries Cisco.
Pris isolément, ces changements pourraient passer pour une succession d’ajustements commerciaux et techniques. Assemblés, ils racontent surtout la fin du modèle historique de Splunk, dans lequel il fallait envoyer toujours davantage de données vers la plateforme pour pouvoir les analyser, atteint ses limites.
Kamal Hathi, patron de Splunk chez Cisco, ne s’en est d’ailleurs pas vraiment caché à Denver. Les clients, reconnaît-il, finissaient par atteindre un plafond budgétaire les obligeant à décider quelles données ils pouvaient encore se permettre d’envoyer dans Splunk. Un casse-tête intenable sur la durée. Un SI moderne produit toujours davantage de logs, de métriques et de traces. Et bien évidemment, le déferlement de l’IA et désormais des agents IA n’a fait qu’augmenter cette pression.
Splunk se devait de casser cette équation qui, au final, transformait l’indispensable observabilité en problème comptable.
La Data Fabric remplace progressivement la gravité des données
C’est probablement le changement le plus important à comprendre derrière les annonces de Denver : Splunk n’exige plus que la donnée vienne systématiquement à lui.
La recherche fédérée (Federated Search), déjà ouverte à Amazon S3 et Snowflake, s’étend à AWS CloudWatch et Databricks. Concrètement, une même requête SPL peut croiser les données opérationnelles indexées dans Splunk avec des données métier stockées dans Snowflake, sans les déplacer ni les dupliquer.
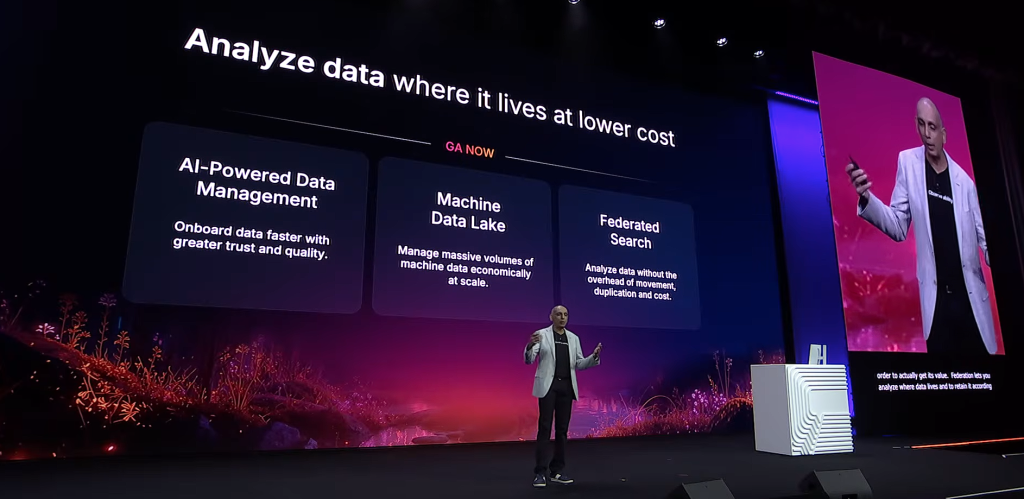
Brique essentielle de cette nouvelle philosophie, le Machine Data Lake, présenté à la .conf25 de Boston et disponible depuis début août sur Splunk Cloud, y compris dans la région de Francfort, prolonge cette logique : il conserve la télémétrie à moindre coût et ne promeut vers l’index qu’une fine tranche de données, au moment précis où une investigation le justifie.
En amont, la gestion des données assistée par l’IA trie et allège les flux avant même leur ingestion. Pour que cette donnée éparpillée reste exploitable, un catalogue interrogeable en MCP (Catalog Discovery) permet aux analystes comme aux agents de localiser les bons jeux de données et d’en comprendre le contexte métier sans savoir à l’avance où ils résident.
L’objectif affiché est d’épargner aux clients l’arbitrage permanent sur ce qu’ils peuvent se permettre d’envoyer à Splunk. Autodesk, cité en exemple, fait état de 28 % d’économies sur l’ingestion et de 78 % sur une charge de recherche déplacée hors de l’index. L’index, qui fut longtemps la raison d’être de Splunk, devient ainsi une option parmi d’autres. La valeur se déplace vers la capacité à corréler ce qui est stocké ailleurs.
Il faut toutefois mettre un bémol de taille : pour les nombreux clients européens restés sur site, cette recherche fédérée étendue ne gagnera Splunk Enterprise que dans le courant de 2027, bien après le cloud.
Ce renoncement à la centralisation des données n’a rien de spontané. Soyons réalistes, il entérine une bataille perdue depuis longtemps. Les SIEM étant facturés au volume, beaucoup d’entreprises ont pris l’habitude de trier leurs journaux avant de les envoyer. D’où le succès d’outils comme Cribl, Vector, Fluent Bit ou le collecteur OpenTelemetry qui filtrent et ne transmettent que l’essentiel, redirigeant le reste vers des espaces de stockage moins coûteux. Et ces espaces ne manquent pas : ClickHouse et sa pile ClickStack, OpenSearch, Grafana Loki ou de simples tables Apache Iceberg interrogées avec Trino permettent désormais de conserver des journaux à très bas prix.
Stocker des logs n’a plus rien d’un savoir-faire rare, c’est devenu un service banalisé. D’ailleurs, et au grand désespoir de Splunk, les grands acteurs du marché en ont tiré les leçons : Snowflake a racheté Observe, Palo Alto Networks s’est offert Chronosphere, CrowdStrike a acquis Onum, et Microsoft a doté Sentinel de son propre lac de données.
Splunk ne cherche donc plus à héberger toutes les données de ses clients. Il veut rester l’outil qui permet de mieux les exploiter, mieux les explorer, mieux les analyser et mieux les comprendre, où qu’elles se trouvent.
Une tarification à l’activité annoncée en catimini
Une annonce relativement discrète pourrait d’ailleurs avoir davantage de conséquences que nombre de démonstrations présentées sur scène : l’Activity-Based Pricing.
Attendue cet automne, cette tarification « à l’activité » doit pondérer à parts égales la recherche et l’ingestion. Splunk avait déjà introduit une facturation basée sur les workloads. Il pousse désormais la logique plus loin en détachant progressivement ses revenus du nombre de gigaoctets indexés.
Et c’est cohérent.
Si une donnée reste chez Databricks ou AWS et que Splunk vient simplement l’interroger, continuer à facturer essentiellement son ingestion devient difficilement défendable. La vraie valeur (et donc mécaniquement la facture) se déplace vers ce que l’on fait de cette donnée.
Cela a d’autant plus de sens que les agents IA risquent précisément de faire exploser cette activité.
Jeetu Patel, président et Chief Product Officer de Cisco, rappelle que les agents consomment depuis février davantage de tokens que les humains et qu’ils en consomment aujourd’hui cinq fois plus. Contrairement à un analyste, un agent ne prend pas de pause, ne rentre pas chez lui le soir et peut interroger les données vingt-quatre heures sur vingt-quatre.
Splunk s’adapte à l’ère agentique
Cette nouvelle grille tarifaire n’est que le symptôme d’une mutation plus profonde : Splunk se réinvente pour des utilisateurs qui ne tapent plus leurs requêtes au clavier. Pendant près de vingt ans, la plateforme a été pensée pour des humains, des analystes rompus au langage SPL qui bâtissaient tableaux de bord et alertes.
Mais en 2026, une part croissante de ses utilisateurs n’a plus de clavier : ce sont des agents IA. Et la plateforme s’adapte.
Grâce au serveur MCP de Splunk et au catalogue évoqué plus haut, ces agents disposent d’un accès normalisé aux données et peuvent trouver seuls les bons jeux de données.
Splunk fournit aussi ses propres agents spécialisés, pour le SOC comme pour l’exploitation : Detection Builder pour concevoir les détections, Triage pour qualifier les alertes, Guided Response pour déclencher des actions de sécurité ou encore AI Troubleshooting pour rechercher les causes d’incidents applicatifs et d’infrastructure.
Splunk propose même un agent de remédiation autonome conçu avec Anthropic : il lit la télémétrie, propose un correctif sous forme de demande de fusion et attend le feu vert d’un humain.
Et l’éditeur développe même ses propres modèles : le Deep Time Series Model de Cisco, spécialisé dans les séries temporelles, n’est que le premier d’une famille de modèles de fondation taillés pour la donnée machine.
Parallèlement, Splunk met à disposition Agent Launchpad, son atelier de création d’agents disponible depuis août sur le cloud : chacun peut assembler son agent sans coder, en choisissant le modèle, les outils et les compétences.
Jeetu Patel résume cette bascule en une formule choc : « L’inférence est la nouvelle charge de travail, les agents la nouvelle main-d’œuvre, les tokens la nouvelle monnaie, et la confiance la nouvelle monnaie de l’adoption ». La confiance était d’ailleurs le fil rouge de toute la conférence
Splunk entend devenir à la fois la mémoire où puise cette main-d’œuvre, l’outil qui la surveille et le compteur qui mesure ce qu’elle coûte.
Avec Tokenomics, Splunk surveille les machines qui consomment l’IA
Preuve en est l’une des grandes annonces de la conférence : Splunk Agent Observability, qui intègre désormais les technologies de Galileo racheté au printemps, arrive dans le cloud. Disponible dans Observability Cloud et sous forme d’application native dans Cisco Cloud Control, la plateforme observe les modèles et les agents, surveille la pile IA des GPU jusqu’aux bases vectorielles et applique des garde-fous à leur exécution.
Elle s’enrichit d’une nouveauté baptisée Tokenomics qui s’attaque à une douleur très concrète : savoir qui consomme quoi. Elle suit les dépenses en tokens aussi bien des agents que celles des développeurs utilisant Claude Code, Codex ou Cursor, impute ces coûts et tente même d’anticiper la consommation avant la fin de la période de facturation grâce au Deep Time Series Model de Cisco.
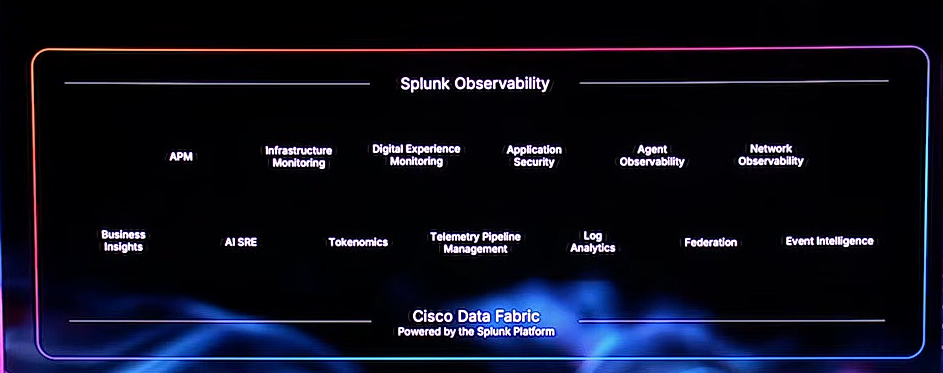
Sur scène, Splunk a démontré le problème avec un agent commercial censé améliorer la satisfaction client. Très zélé, celui-ci continuait d’honorer une promotion expirée de 300 dollars. La réponse a consisté à transformer un évaluateur en garde-fou exécuté par un petit modèle en moins de 350 millisecondes, précisément le savoir-faire apporté par Galileo. Splunk affirme avoir ainsi ramené un coût d’évaluation avoisinant mille dollars par jour à quelques dollars.
Verizon a néanmoins rappelé une évidence parfois oubliée dans les comparatifs de modèles : l’agent le moins cher à l’appel n’est pas forcément le moins coûteux si son faible taux de réussite oblige à recommencer trois fois le travail.
Reste que Splunk débarque sur un marché de l’observabilité agentique très effervescent et encombré. Langfuse (désormais dans le giron de ClickHouse), Arize Phoenix ou OpenLLMetry proposent déjà des mécanismes open source de tracing et d’évaluation des applications GenAI. LiteLLM sait imputer les coûts par équipe. Datadog et Dynatrace ont ajouté l’observabilité des LLM à leurs plateformes.
Alors pourquoi Splunk ? L’éditeur met en avant tout ce qu’il peut connecter autour de cette observabilité.
La nouvelle Network Intelligence App remonte la topologie, l’état des équipements et les événements réseau Cisco. Network Insights exploite les tests synthétiques de ThousandEyes. Observability Studio veut favoriser des applications « nées observables ». Des agents SRE détectent et diagnostiquent les incidents.
Le Splunk de 2026 n’est donc plus seulement l’outil dans lequel on cherche pourquoi une application est tombée à 3 h 17 du matin.
Il veut décider quelles données examiner, identifier ce qui s’est produit, estimer combien l’investigation a coûté et proposer la prochaine action.
Le SOC devient agentique mais la donnée reste le juge de paix
La même logique gagne évidemment la cybersécurité, l’un des grands domaines de prédilection de Splunk.
Avec l’extension de son Agentic SOC Workforce, l’éditeur entend couvrir toute la chaîne opérationnelle : concevoir et ajuster les détections, rechercher les menaces, conduire les investigations et orchestrer la réponse, dans un cadre de gouvernance explicite. La pertinence de ces agents dépend directement du contexte auquel ils accèdent. Les enrichissements d’Exposure Analytics prennent ici leur sens : élargir la découverte des actifs, conserver l’historique de leurs évolutions et tenir compte de leur criticité métier pour hiérarchiser les risques. Les intégrations avec Cisco Hybrid Mesh Firewall rapprochent, quant à elles, les conclusions d’une investigation des équipements capables d’appliquer une mesure de protection. Splunk cherche ainsi à relier les preuves, la décision et l’action, avec des approbations et une traçabilité intégrées.
La concurrence, elle, est déjà là. Palo Alto Networks pousse Cortex XSIAM. CrowdStrike associe Falcon Next-Gen SIEM à Charlotte AI. Microsoft marie Sentinel et Security Copilot. Google, Elastic et Sekoia suivent la même direction. Même dans l’open source, Wazuh, OpenSearch Security Analytics, Sigma, OCSF et les LLM permettent désormais de construire des SOC fortement automatisés.
Alors, pour se différencier, Splunk met plutôt en avant ses quelque 1 300 intégrations et surtout l’arrivée de la télémétrie réseau Cisco dans l’équation.
Car lorsqu’un comportement étrange apparaît dans le SI, encore faut-il savoir ce que l’on regarde. Comme l’a souligné Jeetu Patel, il devient très difficile de distinguer une intrusion, un agent compromis par une injection d’invite et un agent parfaitement sain qui a simplement exécuté ses consignes au pied de la lettre. C’est le nouveau casse-tête des RSSI.
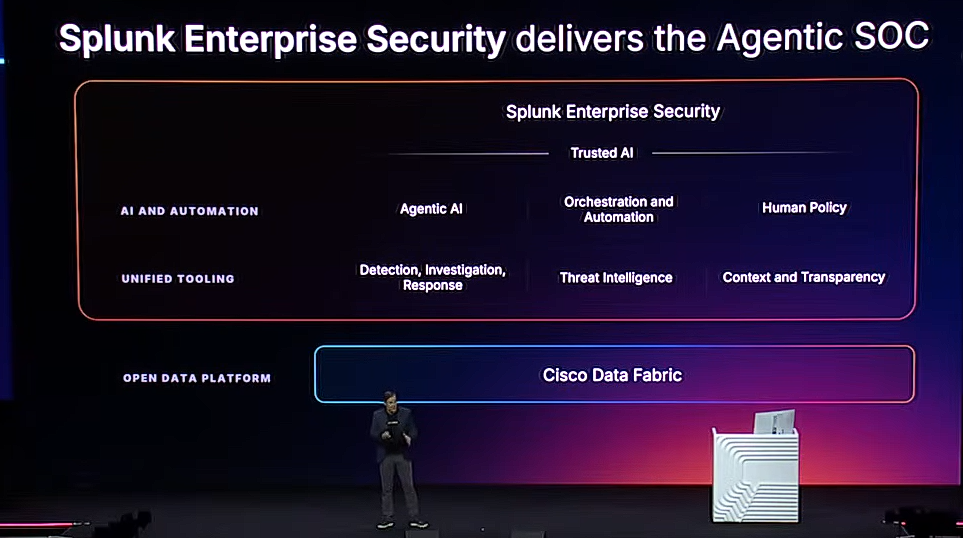
C’est également ce qui explique le rapprochement attendu d’ici la fin de l’année entre les données d’Observability et celles d’Enterprise Security. Les deux mondes ont souvent des équipes et des budgets distincts, reconnaît John Morgan, patron de l’activité sécurité de Splunk, même s’ils poursuivent le même objectif.
Avec AI POD for Splunk, c’est désormais l’IA qui rejoint la donnée
Reste un problème de taille pour Splunk : une partie importante de sa clientèle, notamment en Europe, utilise encore Splunk Enterprise sur site.
Cisco AI POD for Splunk tente de réduire cet écart. Cette déclinaison de la Secure AI Factory conçue avec NVIDIA fournit un environnement Kubernetes validé pour exécuter les fonctions IA de Splunk sur site, dans un cloud privé voire dans des environnements déconnectés.
L’assistant IA y est disponible dès maintenant. Agent Launchpad doit suivre d’ici la fin de l’année. Les clients peuvent également auto-héberger certains modèles, dont le Deep Time Series Model de Cisco, Gemma 4 de Google ou GPT-OSS 20B d’OpenAI, avant l’arrivée annoncée des modèles Nemotron.
Accenture, Wipro, World Wide Technology et bitsIO doivent accompagner les déploiements.
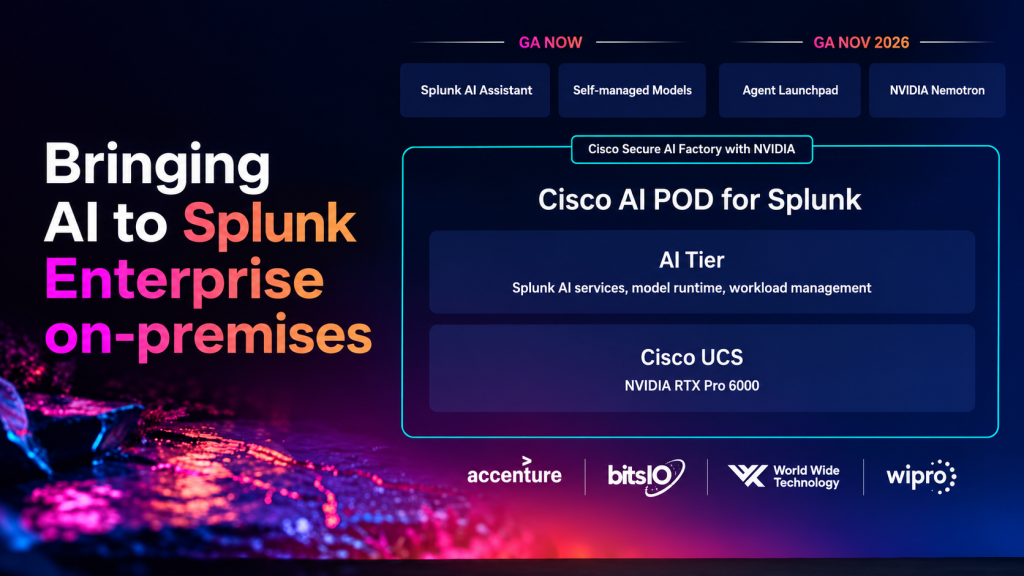
La logique est presque l’inverse du Splunk historique. Avant, on envoyait la donnée vers Splunk. Désormais, Cisco propose d’envoyer Splunk et son IA vers la donnée. Pour les organisations européennes régulées, le mouvement est intéressant. Il ne faut néanmoins pas confondre exécution locale et souveraineté. Conserver les données dans son propre datacenter ne supprime ni la dépendance à une pile matérielle et logicielle américaine ni les contraintes associées à une qualification comme SecNumCloud.
Et rien n’interdit évidemment de servir un modèle ouvert avec vLLM sur un cluster Kubernetes classique. Ce que Cisco vend ici est donc moins l’exclusivité technologique que l’intégration et la validation de bout en bout.
De moteur de recherche des machines à registre de leur comportement
L’éditeur reste profondément ancré dans la donnée produite par les systèmes, les applications, les équipements réseau et les logiciels. Il ne se transforme pas en entrepôt universel destiné à accueillir le CRM, les ventes, le marketing et toute la donnée analytique de l’entreprise.
Mais la définition même de « donnée machine » est en train d’exploser.
Un log est une donnée machine. Une métrique aussi. Une trace OpenTelemetry également. Mais la consommation de tokens d’un agent, sa chaîne de raisonnement observable, ses appels d’outils, ses décisions, ses erreurs et les actions qu’il déclenche constituent désormais eux aussi une forme de télémétrie.
Et c’est là que Splunk veut se placer.
Le stockage peut être assuré ailleurs. L’IA peut venir jusqu’à la donnée. Le prix quitte progressivement l’ingestion pour l’activité. Les compteurs suivent désormais les tokens autant que les logs. Et les agents rejoignent les utilisateurs humains parmi les producteurs et consommateurs de télémétrie.
Splunk cesse progressivement d’être une destination obligatoire pour devenir un point de passage logique. Un registre de ce que font les machines. Et demain, de ce que font les agents.
Le pari reste risqué. La marque Splunk se dilue dans un ensemble de plus en plus centré sur Cisco. La promesse de corrélation entre réseau, sécurité et observabilité devra faire ses preuves dans les environnements réellement hétérogènes des grandes entreprises. Plusieurs briques annoncées à Denver n’arriveront d’ailleurs qu’en 2027.
Malgré la force des annonces et une certaine lucidité, voire franchise affichée lors des Keynotes, il n’est néanmoins pas sûr que cette édition 2026 ait répondu à toutes les questions que se posaient au départ DSI et RSSI.
La facture sera-t-elle enfin prévisible ? La réponse de la .Conf26 est « pas encore ». Splunk change la règle de calcul, pas l’incertitude, surtout quand des agents interrogent la plateforme jour et nuit.
Les clients de Splunk Enterprise, restés sur site par contrainte réglementaire et très nombreux en Europe, auront-ils droit à l’IA ? Oui, mais avec un temps de retard : l’assistant IA dès aujourd’hui, les agents en fin d’année, la recherche fédérée étendue en 2027.
Alors que NIS2 et DORA exigent traçabilité et maîtrise des risques, comment gouverner des agents dont personne ne maîtrise encore ni le comportement ni le coût ? Splunk fournit le tableau de bord, pas le code de la route : mesurer les agents devient possible, décider de ce qu’ils ont le droit de faire reste l’affaire de chaque entreprise.
Alors, oui, cette.conf26 n’a pas tout réglé. Mais elle a au moins eu le mérite de rendre lisible ce que Splunk veut être, et pour un éditeur que beaucoup voyaient se dissoudre dans Cisco, c’est déjà beaucoup. Reste désormais à concrétiser puis imposer cette vision, dans un terrain très mouvant, à la compétition intense. Rendez-vous l’an prochain…
À LIRE AUSSI :
À LIRE AUSSI :
À LIRE AUSSI :